讓照片跟著自己的歌曲唱歌,需要把一張清晰人像和一段帶人聲的錄音交給音訊驅動的影片工具。圖片決定人物外觀,錄音提供歌聲。先做一小段,開聲音檢查嘴型,再考慮更長的版本。
已經有歌,就不需要重新創作。本文用原創中文歌曲《燈火慢》和已有角色圖,先展示單張照片生成的短片,再看三個獨立鏡頭拼接成較長演唱影片後有哪些變化。
先看一張照片、一段歌和對應成片
第一個鏡頭使用《燈火慢》的 Suno B 版本,取原歌 27.75–37.875 秒,搭配下方這張照片。我們已核實:這張輸入圖、這段音訊和完整的 10.125 秒成片來自同一次測試。
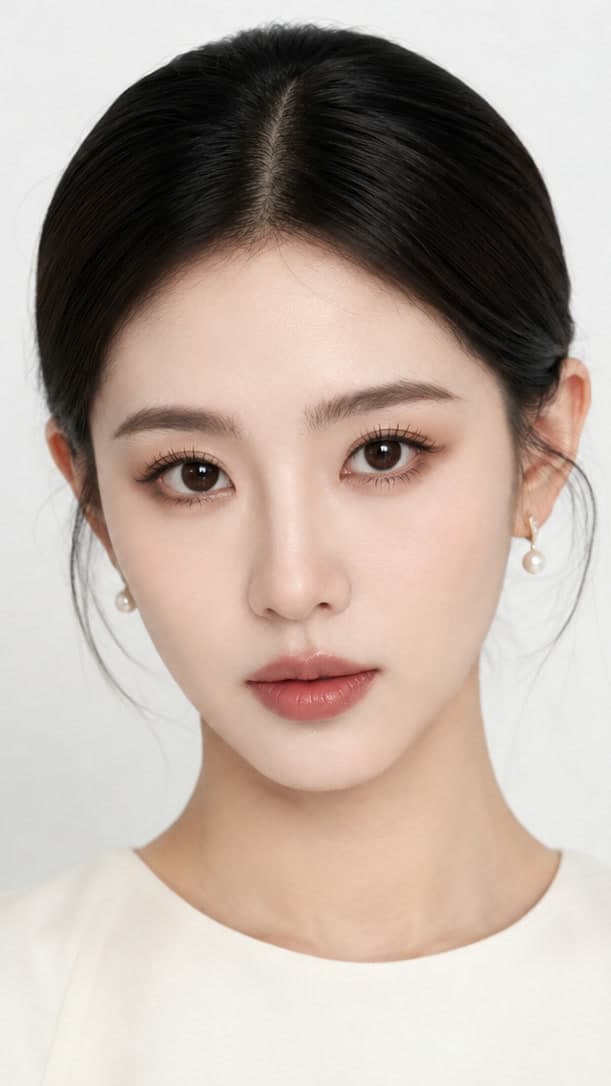
輸入音訊:《燈火慢》B 版,27.75–37.875 秒
這組素材來自音樂工作區上線前的 H3 Enhanced API 測試,三機位版本由 FFmpeg 拼接。它展示的是當時的真實實驗;下文操作步驟對應現在的 FlyAIgh 頁面。
照片為什麼能跟著歌曲唱?
照片唱歌,是讓影片生成工具同時參考人臉圖片和一段音訊。給普通圖生影片後配一首歌,並不會自動讓嘴型跟上歌聲。先按想要的結果選擇做法:
- 想讓人物演唱已有錄音:選「演唱影片」,由選中的歌曲片段驅動各個鏡頭。
- 想讓演唱、故事和風景穿插出現:選「完整 MV」,具體做法見文末的音樂 MV 教程。
- 只想給靜態封面配音樂:用剪輯軟體合成即可,畫面中的人不會因此開口唱歌。
照片本身並不能告訴工具,這個人的聲音是什麼樣。這裡使用的是你提供的錄音,不會克隆照片里人物的聲音、改寫歌詞,也不會把純伴奏唱成新歌。
先選好照片和人聲片段
生成之前,先確認人物的嘴能看清、歌曲的人聲能聽清。構圖不合適或主唱被伴奏蓋住,最好在花點數做長片之前處理。
- 先用一張單人圖。正面或略帶側面的角度更方便觀察嘴型,嘴唇周圍要清楚,構圖也要適合目標畫幅。避免手、麥克風或頭髮擋嘴。
- 選主唱清楚的片段。本例用的是帶伴奏的完整混音,不是單獨的人聲軌,並非每次都必須先分離人聲;但複雜和聲、多人重唱或很強的伴奏會讓判斷更困難。
- 聽一遍片段首尾。初次可選 10–15 秒,儘量包含完整樂句。音量低的地方可能只是句中換氣,不一定適合切開。
- 準備其他機位時,先把幾張圖放在一起,比較頭髮、衣服、耳飾和背景。多一個視角,也多一處可能不一致的輸入。
請使用你有權使用的照片和錄音。本例是接近真人外形的角色圖,不能據此推斷繪畫、動物或多人照片都有相同效果。
在 FlyAIgh 中製作演唱影片
進入音樂工作區,選擇「演唱影片」。初次先選擇單機位和一小段自訂選區;預設選區可能較長,生成前要自己確認。
- 上傳 MP3 或 WAV,也可以選擇工作區裡已經生成的歌。如果歌曲來自 Suno,上傳你有權使用的音訊檔案即可,不能只貼上 Suno 連結。
- 試聽選區,檢查辨識出的歌詞和時間位置,先糾正錯誤,再規劃鏡頭。頁面可以在目前時長限制內選擇整首、副歌或自訂範圍。
- 新增角色照片,選擇單機位並設定畫幅。檢查最終使用的首個影格:可以直接用照片、上傳準備好的畫面,或生成場景圖。新生成的場景圖也要重新檢查。
- 檢查分段計畫和表演提示詞。想看清嘴型,就別同時要求過於複雜的動作。提示詞可以引導表情,不能保證每個細節都照做。
- 選擇 H3 Enhanced 的 480p 或 768p,並核對頁面顯示的點數預估。開始前確認歌曲選段、首個影格和計畫;開始生成後,選區與計畫會鎖定。
- 開聲音播放生成的 MP4,既檢查各段,也檢查拼接後的完整結果。下載的 SRT 歌詞是獨立字幕檔案;要讓字幕顯示在畫面裡,還需要放進剪輯軟體合成。
影片生成需要付費帳戶和點數。自帶歌曲可以省去重新生成歌曲這一步,圖片、影片鏡頭及後續嘗試仍可能消耗點數。以目前頁面預估為準,不沿用歷史測試的費用。
檢視 A 鏡頭當時使用的提示詞
以下保留原始英文指令,描述想要的表情和動作,不代表成片一定逐項做到。
Close-up. The same young woman sings a gentle Mandarin ballad in a softly lit light-grey studio, calm tender expression, natural breathing, subtle head movement, no smiling, steady camera.長歌曲選擇單機位,還是三機位?
只選一個機位,也不一定生成一整段連續長鏡頭。目前「演唱影片」允許選取 10 秒到 6 分鐘,按 5–15 秒安排分段。這是產品時長範圍;我們沒有用本例驗證無縫的六分鐘演唱。
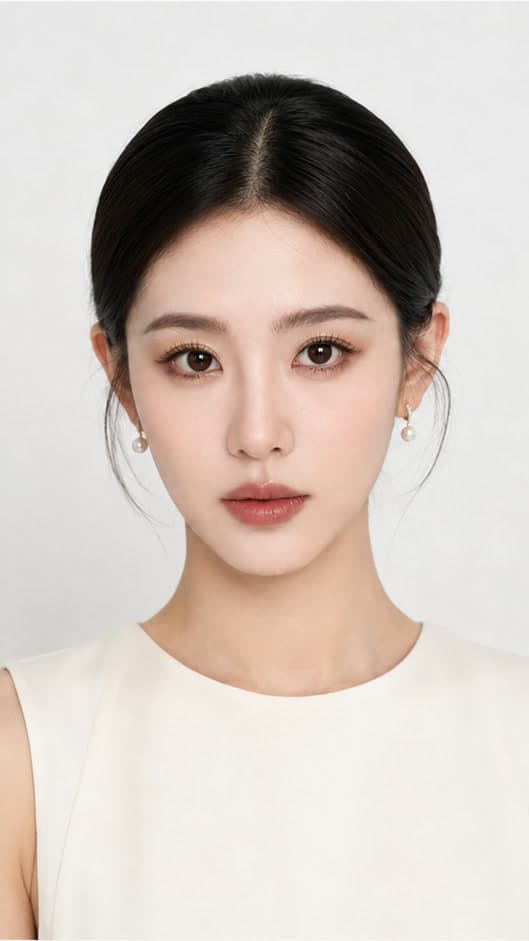
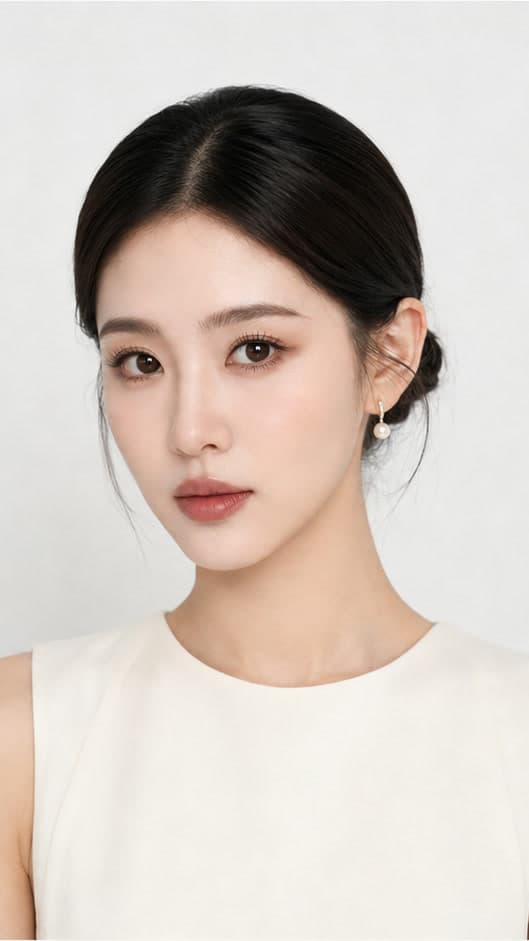
為了觀察切鏡效果,同一測試又準備了這個角色的另外兩張圖。三個鏡頭合起來覆蓋原歌 B 版 27.75–58.25 秒,成片長 30.5 秒。下面是當時真實使用的 B、C 輸入圖。
| 成片時間 | 原歌時間 | 對應圖片與檢查點 |
|---|---|---|
| 0–10.125 秒 | 27.75–37.875 秒 | A:近景,人物在這一段末尾低頭。 |
| 10.125–20.75 秒 | 37.875–48.5 秒 | B:較寬的正面視角,切鏡後重新看向鏡頭,隨後出現微笑。 |
| 20.75–30.5 秒 | 48.5–58.25 秒 | C:三分之四側面,留意頭部角度和嘴型的變化。 |
這兩處切鏡都落在歌詞句中。當時先按音量低點切歌,後來核對歌詞時間,才發現把句中換氣當成了句間停頓。現在的規劃流程會參考歌詞時間選擇邊界,生成後仍要聽、要看。這裡的三機位是同一角色的不同生成視角輪換,不是三臺攝像機同步實拍。
怎樣檢查嘴型、表情和切鏡
先完整播放一遍,再回看開頭、10.125 秒和 20.75 秒附近的切鏡,以及最後一句。這個例子裡,音樂連續播放,人物畫面卻會切換。檢查時要分別看下面幾項:
- 嘴型:對照起唱、停頓、拖長音和閉唇音,看看嘴部動作是否跟上聲音。嘴巴一直動,或者背景音樂正確,都不足以說明嘴型準確。
- 表情:A 鏡頭末尾低頭,B 鏡頭又重新直視鏡頭。B 還出現了提示詞原本要求避免的微笑。需要判斷這樣的表演是否適合歌曲。
- 切鏡與構圖:第一次切鏡變成更寬的景別,頭位也發生變化;第二次換到側面。開聲音檢查接縫,不要把獨立生成的幾個鏡頭當成連續實拍。
- 音訊與結尾:檢查有沒有重複歌詞、缺聲、音量突變或樂句沒唱完就停下。這段成片的終點在原歌中間,並不是整首歌曲的結尾。
再嘗試時,先改輸入:換更清楚的照片、主唱更突出的選段,或更合適的樂句邊界,可能比堆提示詞更有用。目前結果頁能重試失敗或未開始的鏡頭,不能任意重做已完成的鏡頭;想修改已經鎖定的選區或計畫,需要新建專案。
這個案例是怎樣核實的
我們核對了原始歌曲、圖片裁切、上傳檔案雜湊、生成記錄、單鏡頭影片和拼接命令,並對完整成片做了工具輔助的有聲審查,檢查了三個鏡頭全段的畫面。音訊比對只用於確認來源,不能據此給出嘴型準確率、成功率,也不能推斷每種語言都有同樣效果。
想進一步瞭解這類做法,可以看 HeyGen 對照片與音訊輸入的說明,以及 TalkPix 關於人聲清晰度、嘴部可見性的建議。這些是廠商自己的說明,不是對 FlyAIgh 的獨立評測。
常見問題
照片會改變我歌曲裡的聲音嗎?
不會。這個流程裡,錄音提供聲音,照片決定外觀。它不是聲音複製,也不會讓另一個歌手重新翻唱。
能用自己的錄音或 Suno 歌曲嗎?
可以,上傳你有權使用的 MP3 或 WAV 即可,不需要重新生成歌曲。Suno 歌曲也需要上傳音訊檔案,不能只提供連結。
必須先把伴奏去掉嗎?
不一定。本例使用的就是帶伴奏的歌曲。先選主唱清楚的片段,再檢查結果;不能據此保證複雜混音或多人重唱都能對好嘴型。
一張照片能唱完整首歌嗎?
目前「演唱影片」允許選擇 10 秒到 6 分鐘。較長選段會分片生成,單機位也一樣,需要檢查拼接處。本文最長案例是 30.5 秒,沒有驗證六分鐘長片。
為什麼切換鏡頭時,臉或表情會突然變化?
每段從各自的輸入畫面開始,頭部角度、視線和嘴型可能在切鏡時重新起步。生成前對照幾張輸入圖,並選好樂句邊界;多機位本身不能保證動作無縫。
能不能只重做嘴型不好的那一鏡?
目前結果頁可以重試失敗或未開始的鏡頭,不能任意重做已完成的鏡頭。開始生成後,選區和計畫會鎖定;要修改計畫,需要新建專案。
換成其他語言的歌,效果也一樣嗎?
這個案例還不能證明。實測歌曲是華語,文章譯文、介面語言、音訊辨識和嘴型效果是不同的事,需要用自己的歌曲檢查。
在 FlyAIgh 讓照片唱歌免費嗎?
影片生成需要付費帳戶和點數。請檢視目前圖片、鏡頭的點數預估,並為可能的再次嘗試留出餘量。