用已有歌曲和角色照片製作 AI 音樂 MV,可以先選一段歌,確定角色外觀,再安排演唱、劇情和空鏡。為各鏡頭準備畫面,生成片段,最後帶著原曲檢查合成結果。照片決定人物長什麼樣,聲音則來自你提供的歌曲錄音。
下面用一個 48 秒的 FlyAIgh 專案說明。已有歌曲就可以從選段開始,適合做副歌預告或新歌宣傳短片;本文的流程不承諾一鍵完成整首歌的敘事 MV。
先看同一首歌、角色圖和完整成片
這個專案使用已選定的 Suno 歌曲《Last Train Home》,取其中 0:51 到 1:39。寫作前,我們核對了專案中儲存的歌曲、角色參考圖、分鏡圖片、五段生成影片和最終成片,確認它們屬於同一條製作流程。
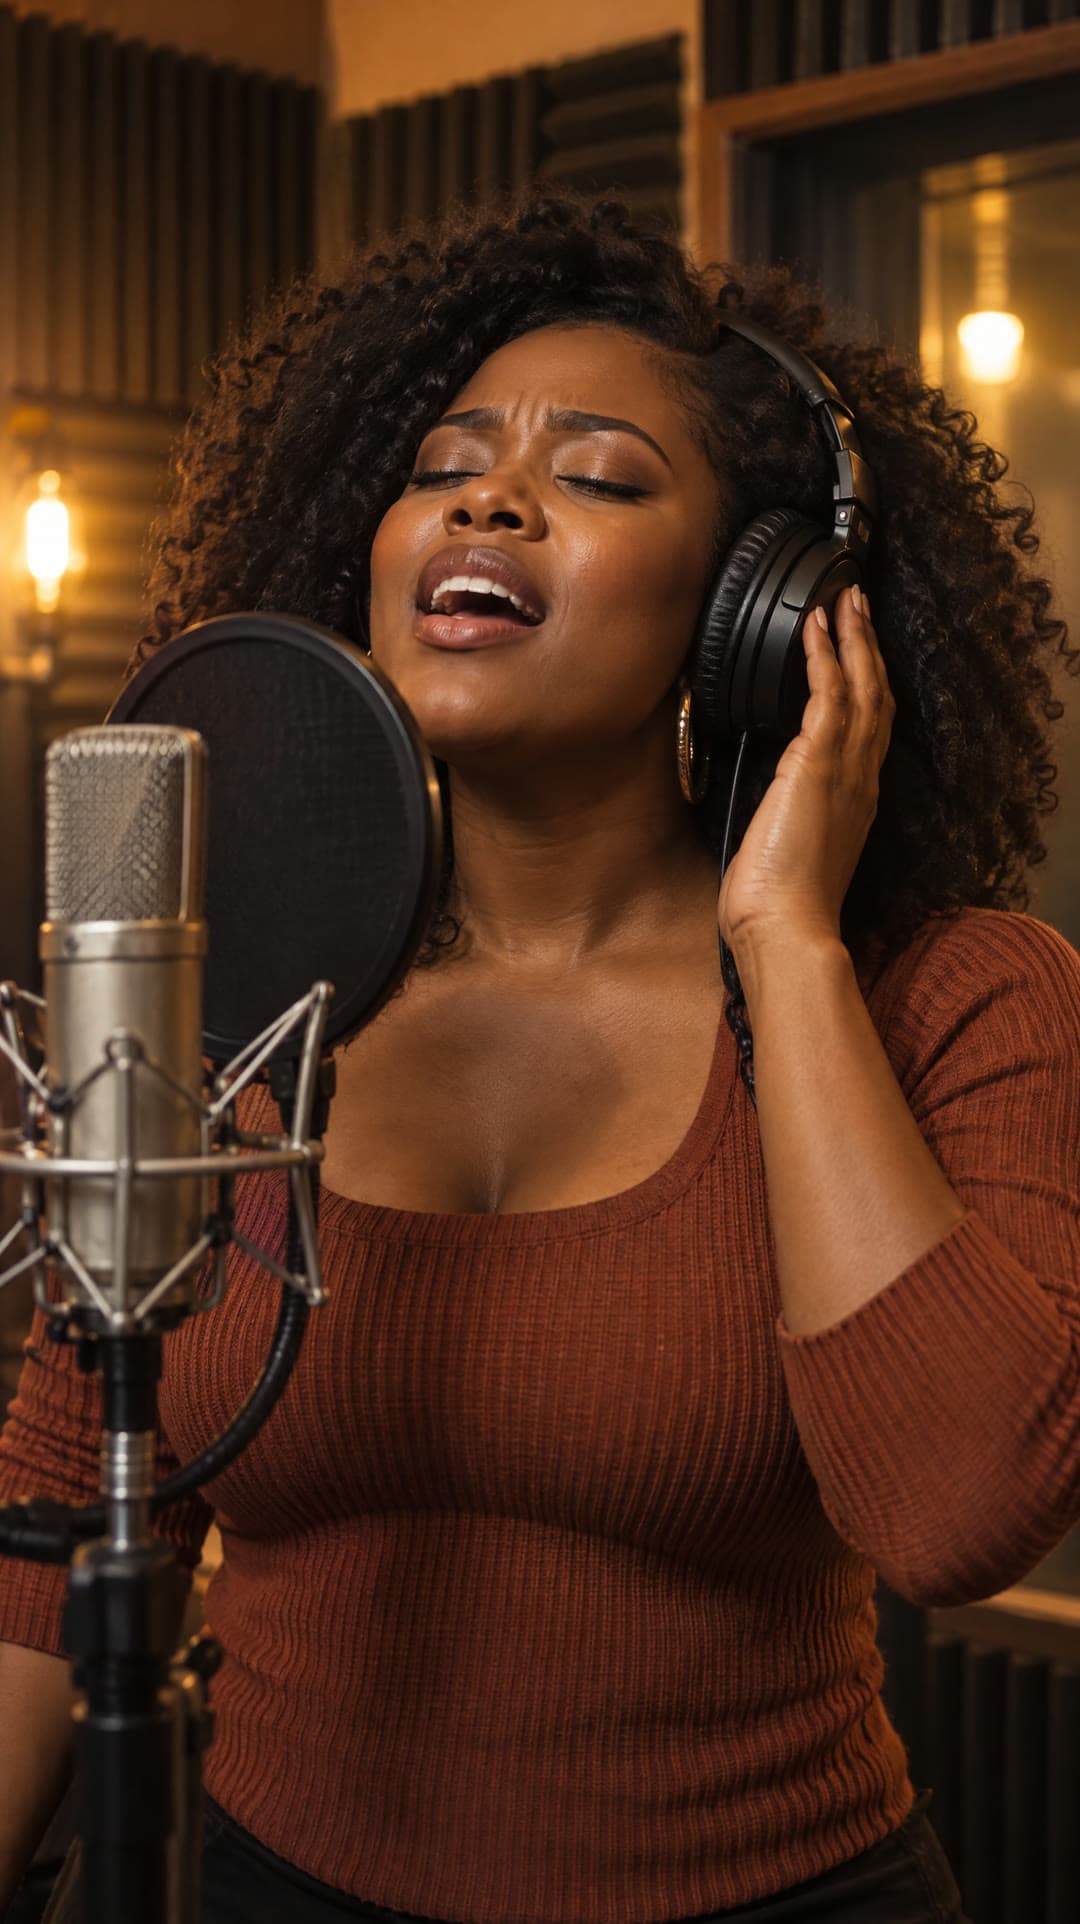
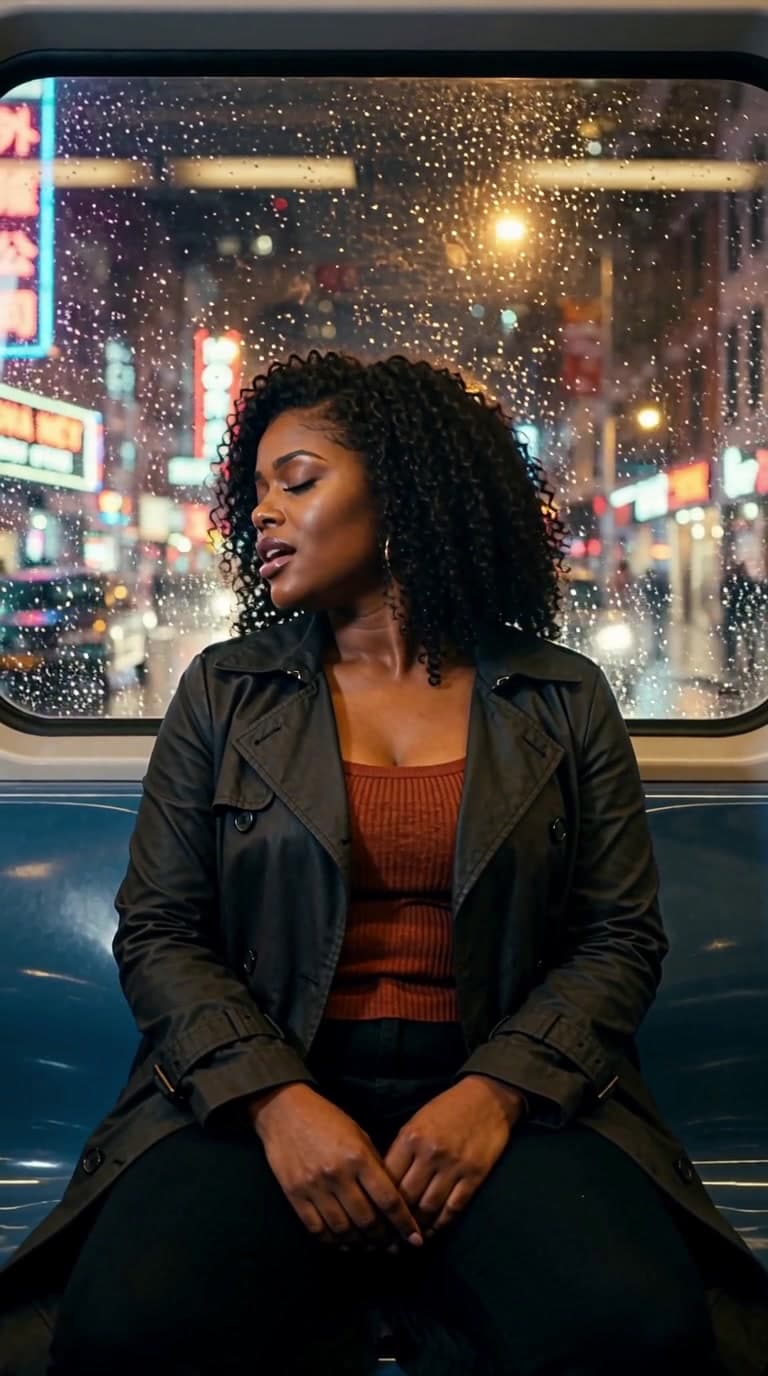
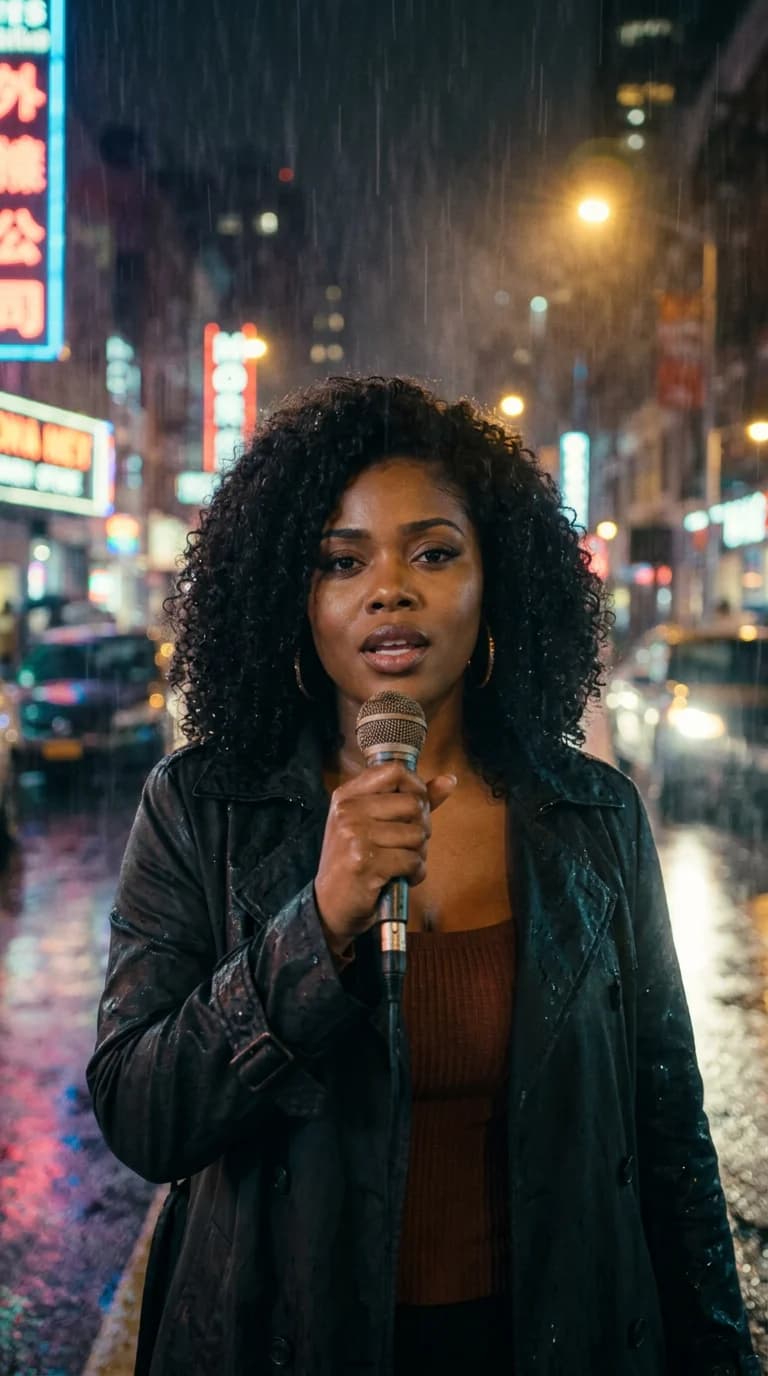
歌曲片段:Last Train Home,0:51–1:39
畫面從列車內演唱開始,接著是街頭持麥、雨夜行走、高架列車空鏡,最後回到歌手。行走和空鏡期間,歌曲仍在繼續。沒有歌手出鏡,並不意味著這一段必須沒有人聲。
人物依然可辨認,但跨鏡頭的外套材質和剪裁有變化。行走鏡頭先從正面靠近人物,再移到側面,沒有全程按提示詞要求側向跟拍。這些都值得在審片時檢查,不能只看到人物相似,就認定角色和運鏡完全符合要求。
讓照片唱歌,還是做一段音樂 MV?
先確定你要的畫面。搜尋“AI 音樂 MV 生成器”,可能會遇到幾種不同的做法:
- 讓照片唱歌:如果重點是讓一個人物跟著錄音演唱,可以用演唱影片流程。嘴部要看得清,並選擇能用音訊驅動嘴型的選項。
- 製作多鏡頭 MV:如果希望演唱、人物動作和環境共同講故事,就需要分鏡。並非每一鏡都要有人張嘴唱歌。
- 製作音樂視覺化:如果只需要抽象動態、封面動畫或波形畫面,就不必讓人物演唱。給畫面配上音樂,本身不會讓嘴型跟著歌曲變化。
FlyAIgh 的音樂 MV 模式目前製作歌曲中的 30–60 秒。單獨的演唱影片模式可選 10 秒到 6 分鐘,但較長的演唱影片和整首歌的多鏡頭敘事 MV 是不同流程。
先選歌曲片段,再安排每一鏡
選段時先聽歌,別隻填時長。儘量從一句開始前切入,給句尾留空間,再聽進入副歌時是否自然。這個案例把歌曲的 0:51–1:39 變成成片中的 0:00–0:48。下面使用成片時間,方便邊看邊核對。
| 影片時間 | 鏡頭型別 | 作用 |
|---|---|---|
| 0:00–0:11 | 演唱 | 列車窗邊的演唱,交代人物與歸途。 |
| 0:11–0:22 | 演唱 | 街頭表演讓歌手更靠近觀眾。 |
| 0:22–0:33 | 劇情 | 角色穿過溼滑街道,推動旅程,同時歌曲繼續。 |
| 0:33–0:41 | 空鏡 | 駛過的火車和倒影展示城市;人聲在畫外繼續。 |
| 0:41–0:48 | 演唱 | 影片回到歌手,呈現所選片段的收尾句。 |
每一鏡先定一個用途。這份分鏡在演唱和情境之間切換,沒有把每句歌詞都做成人物特寫。分鏡出來後,要對著實際歌詞試聽切點;歌詞時間軸能幫助安排剪輯,但不保證每次切鏡都準確卡在鼓點上。
檢視列車鏡頭當時使用的英文提示詞
以下是專案分鏡中記錄的原文,描述當時想要的場景與運鏡。它是生成要求,不代表成片已經實現了每個細節。
She sits by the window of a night train, rain streaking the glass and neon city lights sliding past behind her; she sings softly to herself, eyes half-closed, lost in the memory. Slow gentle push-in.在 FlyAIgh 中完成製作
新建專案時,可以從當前的音樂工作區開始。上面的歷史案例用了單獨的列車圖和共用的主角場景圖,並沒有為每一鏡都單獨生成首幀。當前流程支援在生成影片前逐鏡檢查首幀。
- 上傳已有的 MP3 或 WAV,選擇音樂 MV。使用 Suno 歌曲時,上傳你有權使用的音訊檔案即可,不需要重新生成歌曲,也不是貼上 Suno 連結匯入。
- 選取 30–60 秒,先試聽開頭和結尾,再檢查歌詞及時間軸。識別有誤就修正,需要時匯入 LRC;儘量先校準歌詞,再安排切鏡。
- 上傳角色參考圖,選擇視覺風格。把人物服裝和場景分開描述;需要連續的鏡頭,先統一發型、外套、配飾和麥克風。重新準備人物圖時,選五官清楚、無遮擋的畫面。
- 檢查分鏡裡的演唱、劇情和空鏡型別,以及各鏡的時長和提示詞。生成影片前逐鏡檢視或替換首幀:空鏡裡不要誤帶歌手,演唱鏡頭則要看得清嘴。
- 選擇影片模型,核對報價。H3 增強版演唱鏡頭會用對應歌曲片段驅動;這個工作區的 Seedance 選項不保證口型同步。開始前確認圖片、歌曲選段和分鏡都正確。
- 等各鏡生成完成,帶聲音檢查合成 MP4。需要歌詞時另行下載 SRT。SRT 不會自動變成 MP4 畫面裡的字幕,要顯示歌詞,還需在剪輯軟體中加入並匯出。
影片生成需要付費帳戶和點數,生成圖片、影片及追加嘗試都會影響成本。已有歌就不需要再生成一首。提交前檢視當前頁面的報價,不根據這條樣片估算自己的費用。
完整審片:嘴型、角色和接縫
先帶聲音完整播放一遍,再逐個回看切鏡和演唱段。這個案例需要重點看 0:11、0:22、0:33、0:41,以及整段的開頭和結尾。
- 聽音軌:對照所選歌曲片段,檢查有沒有漏詞、重複、音量突變或句尾被切斷。原曲在這段之後還有內容;影片裡的淡出只是選段收尾。
- 看嘴型:把聽到的歌詞和演唱鏡頭中的嘴部動作對照。配樂正確,不代表子音、停頓和拖長音都對得上;嘴巴會動也不等於對口型合格。
- 看人物和動作:檢查眼睛、握麥的手、髮型、外套和道具。在切鏡處暫停,對比首幀。本例的外套差異,在輸入圖裡就已經存在。
- 看剪輯:分清有意換場景和意外跳切。空鏡要接得上歌曲的情緒,結尾也要給畫面留出落穩的時間。最後判斷的是合成後的整片,不能只看單鏡。
生成失敗時,結果頁可以重試失敗或尚未開始的鏡頭。但這不等於能隨意重剪已經完成的專案:生成一旦啟動,歌曲選段和分鏡就會鎖定。這些選擇應在開始前確認;之後需要改變時,要另建專案。
案例核查與延伸閱讀
本案例對照了儲存的專案與生成記錄、原始素材、完整成片和音軌。音訊比較用於確認歌曲選段,沒有拿它給嘴型同步打分。全片做過工具輔助的有聲審查,也逐鏡檢查了畫面;這些核查不能證明逐幀口型精準、成功率,或其他語言的歌曲也會得到同樣效果。
想比較不同做法,可以看 Adobe 對“生成短鏡頭,再加入音樂”的說明,以及 OpenArt 從音訊開始規劃音樂影片的介紹。這些是廠商自己的流程說明,不是 FlyAIgh 的獨立評測,也不能證明本例嘴型完美。
常見問題
照片會改變歌手的聲音嗎?
不會。角色照片決定外觀,上傳的錄音提供聲音。讓照片中的人物看起來在唱歌,不是聲音克隆,也不會把歌曲重新唱成這個人的聲音。
我可以使用自己的歌或 Suno 歌曲嗎?
可以,請上傳你有權使用的 MP3 或 WAV。本示例中的歌曲由 Suno 生成,並且在規劃影片前已被選定。使用該工作流本身不會授予你對他人錄音或圖片的權利。
我能把整首歌變成敘事音樂MV嗎?
目前 FlyAIgh 的音樂 MV 模式製作 30–60 秒選段。另一個演唱影片模式支援 10 秒到 6 分鐘,但它側重人物演唱,不等於整首歌的多鏡頭敘事 MV。
所有鏡頭都需要口型同步嗎?
不需要。演唱鏡頭需要音訊驅動嘴型;劇情和空鏡可以繼續播放同一首歌,而不出現歌手。本例的列車空鏡中,人聲仍在繼續。
為什麼角色在鏡頭之間換了衣服?
先對比輸入圖片。固定人臉參考,不會同時鎖住每件衣服、道具和光線。把服裝描述清楚,將各鏡首幀放在一起檢查,再生成影片。本例列車圖和街頭圖的外套質感原本就不同。
這適用於其他語言的歌曲嗎?
可以按同樣流程準備,但介面語言、歌詞識別和實際演唱效果是不同的事,仍需針對歌曲檢查。本例是英文歌;文章有多種譯文,不代表已經測試過所有這些語言的歌曲。
我可以下載帶螢幕歌詞的影片嗎?
工作區會分別匯出影片和 SRT 歌詞檔案。要在畫面中顯示歌詞,請將 SRT 匯入影片編輯器,並將字幕渲染進最終匯出。
在 FlyAIgh 中製作AI音樂MV免費嗎?
不免費。影片生成需要付費帳戶和點數。請檢視圖片和影片的當前報價,並為重試預留成本。上傳你已有的歌曲不會使影片生成步驟免費。