让照片跟着自己的歌曲唱歌,需要把一张清晰人像和一段带人声的录音交给音频驱动的视频工具。图片决定人物外观,录音提供歌声。先做一小段,开声音检查嘴型,再考虑更长的版本。
已经有歌,就不需要重新创作。本文用原创中文歌曲《灯火慢》和已有角色图,先展示单张照片生成的短片,再看三个独立镜头拼接成较长演唱视频后有哪些变化。
先看一张照片、一段歌和对应成片
第一个镜头使用《灯火慢》的 Suno B 版本,取原歌 27.75–37.875 秒,搭配下方这张照片。我们已核实:这张输入图、这段音频和完整的 10.125 秒成片来自同一次测试。
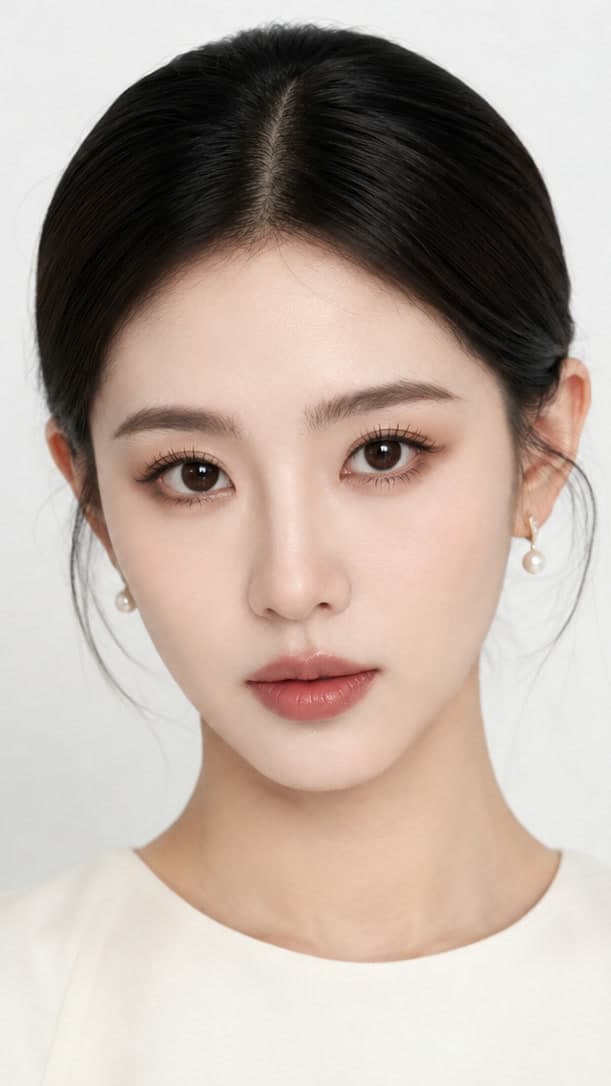
输入音频:《灯火慢》B 版,27.75–37.875 秒
这组素材来自音乐工作区上线前的 H3 Enhanced API 测试,三机位版本由 FFmpeg 拼接。它展示的是当时的真实实验;下文操作步骤对应现在的 FlyAIgh 页面。
照片为什么能跟着歌曲唱?
照片唱歌,是让视频生成工具同时参考人脸图片和一段音频。给普通图生视频后配一首歌,并不会自动让嘴型跟上歌声。先按想要的结果选择做法:
- 想让人物演唱已有录音:选“演唱视频”,由选中的歌曲片段驱动各个镜头。
- 想让演唱、故事和风景穿插出现:选“完整 MV”,具体做法见文末的音乐 MV 教程。
- 只想给静态封面配音乐:用剪辑软件合成即可,画面中的人不会因此开口唱歌。
照片本身并不能告诉工具,这个人的声音是什么样。这里使用的是你提供的录音,不会克隆照片里人物的声音、改写歌词,也不会把纯伴奏唱成新歌。
先选好照片和人声片段
生成之前,先确认人物的嘴能看清、歌曲的人声能听清。构图不合适或主唱被伴奏盖住,最好在花积分做长片之前处理。
- 先用一张单人图。正面或略带侧面的角度更方便观察嘴型,嘴唇周围要清楚,构图也要适合目标画幅。避免手、麦克风或头发挡嘴。
- 选主唱清楚的片段。本例用的是带伴奏的完整混音,不是单独的人声轨,并非每次都必须先分离人声;但复杂和声、多人重唱或很强的伴奏会让判断更困难。
- 听一遍片段首尾。初次可选 10–15 秒,尽量包含完整乐句。音量低的地方可能只是句中换气,不一定适合切开。
- 准备其他机位时,先把几张图放在一起,比较头发、衣服、耳饰和背景。多一个视角,也多一处可能不一致的输入。
请使用你有权使用的照片和录音。本例是接近真人外形的角色图,不能据此推断绘画、动物或多人照片都有相同效果。
在 FlyAIgh 中制作演唱视频
进入音乐工作区,选择“演唱视频”。初次先选单机位和一小段自定义选区;默认选区可能较长,生成前要自己确认。
- 上传 MP3 或 WAV,也可以选择工作区里已经生成的歌。如果歌曲来自 Suno,上传你有权使用的音频文件即可,不能只粘贴 Suno 链接。
- 试听选区,检查识别出的歌词和时间位置,先纠正错误,再规划镜头。页面可以在当前时长限制内选择整首、副歌或自定义范围。
- 添加角色照片,选单机位并设置画幅。检查最终使用的首帧:可以直接用照片、上传准备好的画面,或生成场景图。新生成的场景图也要重新检查。
- 检查分段计划和表演提示词。想看清嘴型,就别同时要求过于复杂的动作。提示词可以引导表情,不能保证每个细节都照做。
- 选择 H3 Enhanced 的 480p 或 768p,并核对页面显示的积分预估。开始前确认歌曲选段、首帧和计划;开始生成后,选区与计划会锁定。
- 开声音播放生成的 MP4,既检查各段,也检查拼接后的完整结果。下载的 SRT 歌词是独立字幕文件;要让字幕显示在画面里,还需要放进剪辑软件合成。
视频生成需要付费账户和积分。自带歌曲可以省去重新生成歌曲这一步,图片、视频镜头及后续尝试仍可能消耗积分。以当前页面预估为准,不沿用历史测试的费用。
查看 A 镜头当时使用的提示词
以下保留原始英文指令,描述想要的表情和动作,不代表成片一定逐项做到。
Close-up. The same young woman sings a gentle Mandarin ballad in a softly lit light-grey studio, calm tender expression, natural breathing, subtle head movement, no smiling, steady camera.长歌曲选单机位,还是三机位?
只选一个机位,也不一定生成一整段连续长镜头。当前“演唱视频”允许选取 10 秒到 6 分钟,按 5–15 秒安排分段。这是产品时长范围;我们没有用本例验证无缝的六分钟演唱。
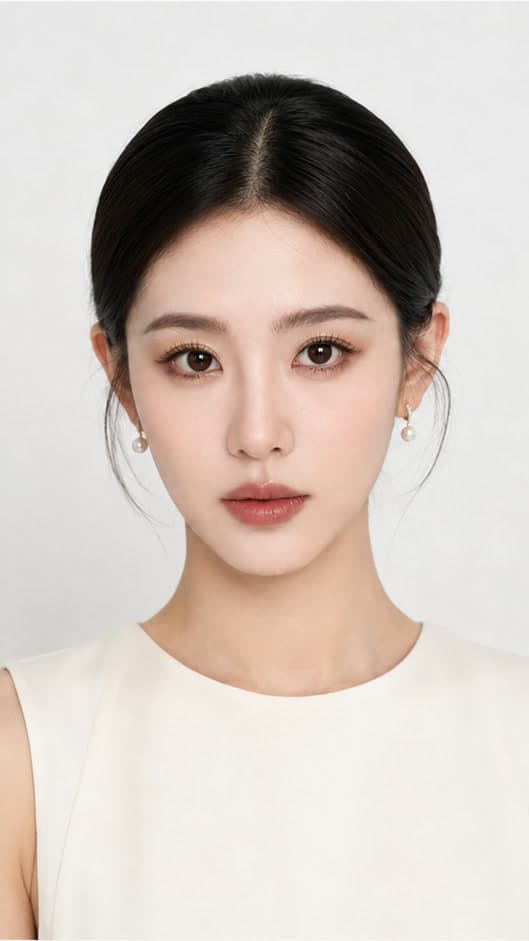
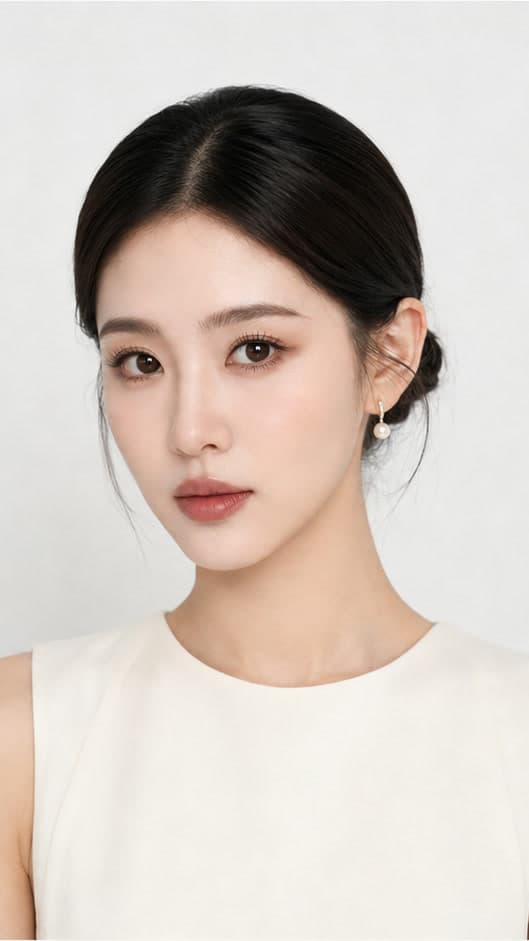
为了观察切镜效果,同一测试又准备了这个角色的另外两张图。三个镜头合起来覆盖原歌 B 版 27.75–58.25 秒,成片长 30.5 秒。下面是当时真实使用的 B、C 输入图。
| 成片时间 | 原歌时间 | 对应图片与检查点 |
|---|---|---|
| 0–10.125 秒 | 27.75–37.875 秒 | A:近景,人物在这一段末尾低头。 |
| 10.125–20.75 秒 | 37.875–48.5 秒 | B:较宽的正面视角,切镜后重新看向镜头,随后出现微笑。 |
| 20.75–30.5 秒 | 48.5–58.25 秒 | C:三分之四侧面,留意头部角度和嘴型的变化。 |
这两处切镜都落在歌词句中。当时先按音量低点切歌,后来核对歌词时间,才发现把句中换气当成了句间停顿。现在的规划流程会参考歌词时间选择边界,生成后仍要听、要看。这里的三机位是同一角色的不同生成视角轮换,不是三台摄像机同步实拍。
怎样检查口型、表情和切镜
先完整播放一遍,再回看开头、10.125 秒和 20.75 秒附近的切镜,以及最后一句。这个例子里,音乐连续播放,人物画面却会切换。检查时要分别看下面几项:
- 口型:对照起唱、停顿、拖长音和闭唇音,看看嘴部动作是否跟上声音。嘴巴一直动,或者背景音乐正确,都不足以说明口型准确。
- 表情:A 镜头末尾低头,B 镜头又重新直视镜头。B 还出现了提示词原本要求避免的微笑。需要判断这样的表演是否适合歌曲。
- 切镜与构图:第一次切镜变成更宽的景别,头位也发生变化;第二次换到侧面。开声音检查接缝,不要把独立生成的几个镜头当成连续实拍。
- 音频与结尾:检查有没有重复歌词、缺声、音量突变或乐句没唱完就停下。这段成片的终点在原歌中间,并不是整首歌曲的结尾。
再尝试时,先改输入:换更清楚的照片、主唱更突出的选段,或更合适的乐句边界,可能比堆提示词更有用。当前结果页能重试失败或未开始的镜头,不能任意重做已完成的镜头;想修改已经锁定的选区或计划,需要新建项目。
这个案例是怎样核实的
我们核对了原始歌曲、图片裁切、上传文件指纹、生成记录、单镜头视频和拼接命令,并对完整成片做了工具辅助的有声审查,检查了三个镜头全段的画面。音频比对只用于确认来源,不能据此给出口型准确率、成功率,也不能推断每种语言都有同样效果。
想进一步了解这类做法,可以看 HeyGen 对照片与音频输入的说明,以及 TalkPix 关于人声清晰度、嘴部可见性的建议。这些是厂商自己的说明,不是对 FlyAIgh 的独立评测。
常见问题
照片会改变我歌曲里的声音吗?
不会。这个流程里,录音提供声音,照片决定外观。它不是声音克隆,也不会让另一个歌手重新翻唱。
能用自己的录音或 Suno 歌曲吗?
可以,上传你有权使用的 MP3 或 WAV 即可,不需要重新生成歌曲。Suno 歌曲也需要上传音频文件,不能只提供链接。
必须先把伴奏去掉吗?
不一定。本例使用的就是带伴奏的歌曲。先选主唱清楚的片段,再检查结果;不能据此保证复杂混音或多人重唱都能对好口型。
一张照片能唱完整首歌吗?
当前“演唱视频”允许选择 10 秒到 6 分钟。较长选段会分片生成,单机位也一样,需要检查拼接处。本文最长案例是 30.5 秒,没有验证六分钟长片。
为什么切换镜头时,脸或表情会突然变化?
每段从各自的输入画面开始,头部角度、视线和嘴型可能在切镜时重新起步。生成前对照几张输入图,并选好乐句边界;多机位本身不能保证动作无缝。
能不能只重做口型不好的那一镜?
当前结果页可以重试失败或未开始的镜头,不能任意重做已完成的镜头。开始生成后,选区和计划会锁定;要修改计划,需要新建项目。
换成其他语言的歌,效果也一样吗?
这个案例还不能证明。实测歌曲是普通话,文章译文、界面语言、音频识别和嘴型效果是不同的事,需要用自己的歌曲检查。
在 FlyAIgh 让照片唱歌免费吗?
视频生成需要付费账户和积分。请查看当前图片、镜头的积分预估,并为可能的再次尝试留出余量。