用已有歌曲和角色照片制作 AI 音乐 MV,可以先选一段歌,确定角色外观,再安排演唱、剧情和空镜。为各镜头准备画面,生成片段,最后带着原曲检查合成结果。照片决定人物长什么样,声音则来自你提供的歌曲录音。
下面用一个 48 秒的 FlyAIgh 项目说明。已有歌曲就可以从选段开始,适合做副歌预告或新歌宣传短片;本文的流程不承诺一键完成整首歌的叙事 MV。
先看同一首歌、角色图和完整成片
这个项目使用已选定的 Suno 歌曲《Last Train Home》,取其中 0:51 到 1:39。写作前,我们核对了项目中保存的歌曲、角色参考图、分镜图片、五段生成视频和最终成片,确认它们属于同一条制作流程。
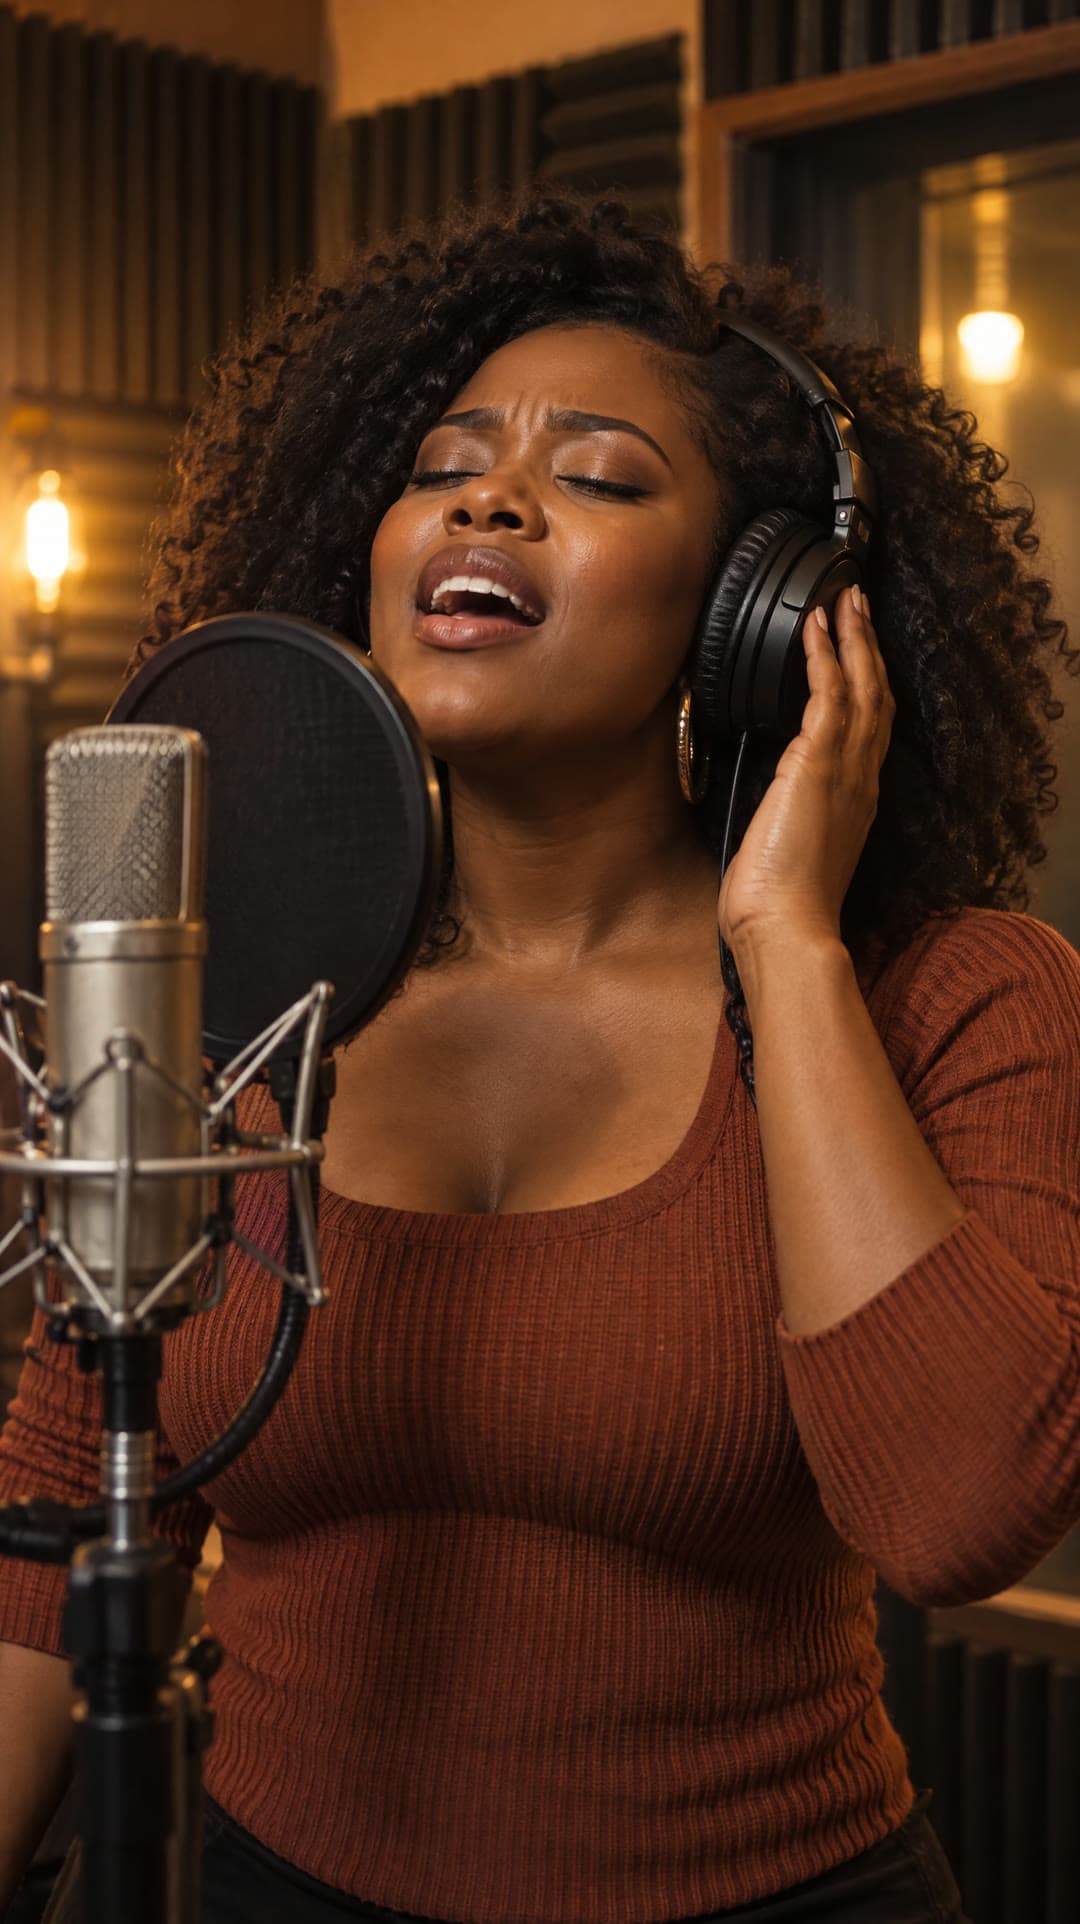
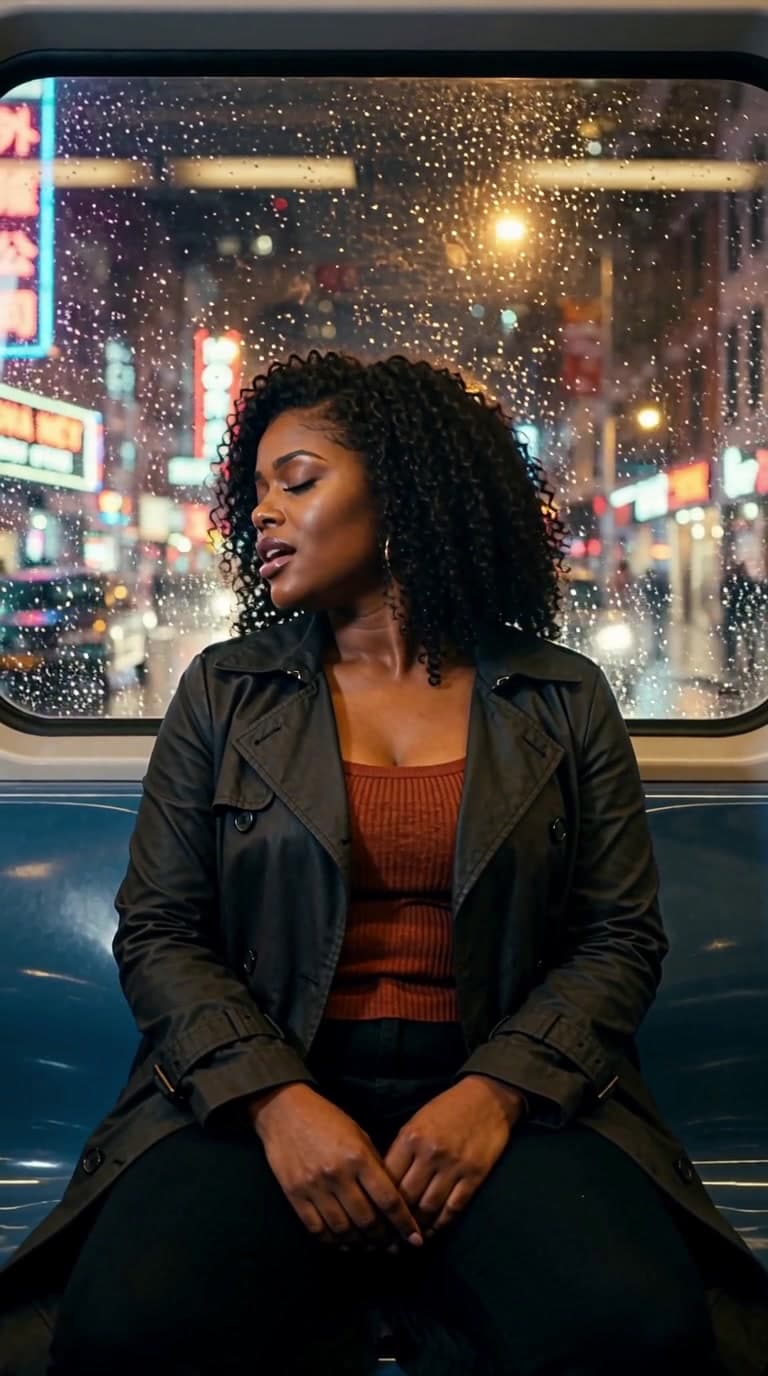
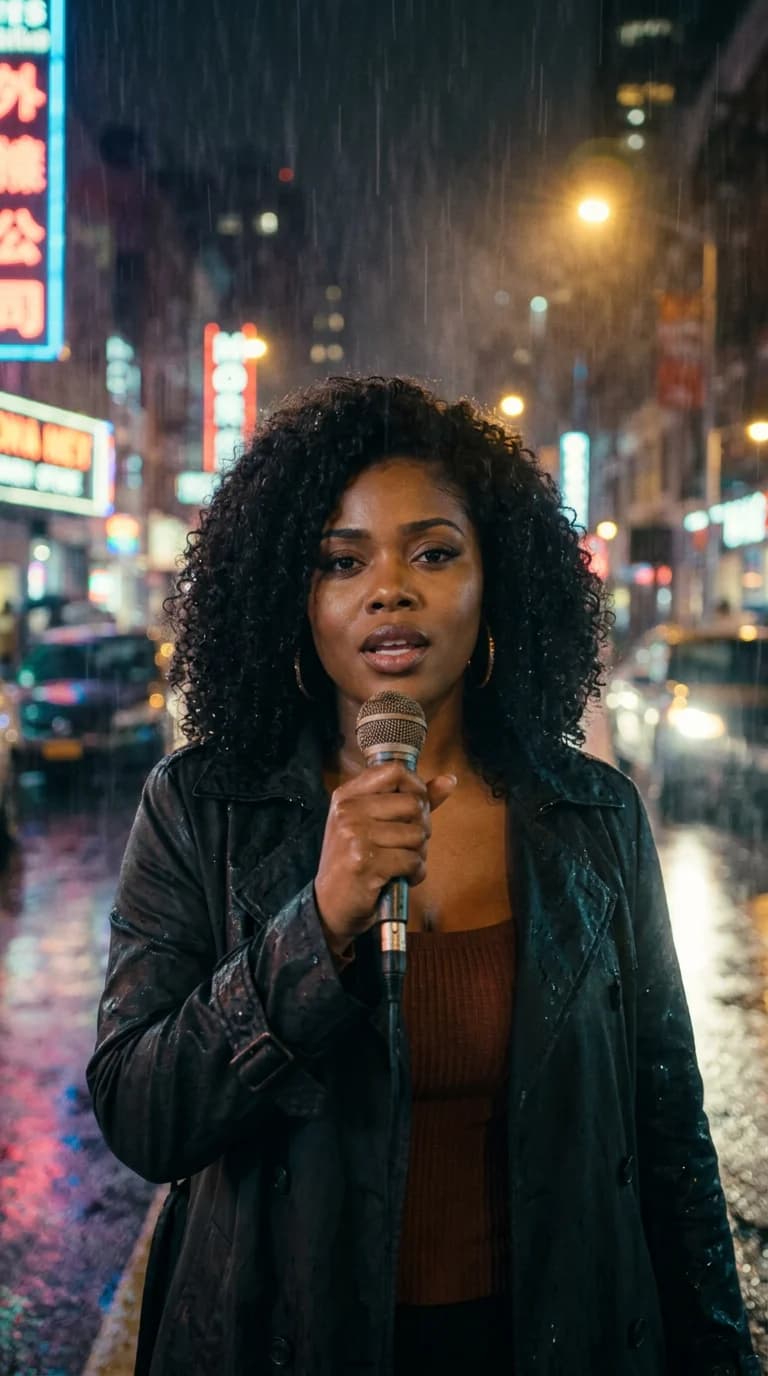
歌曲片段:Last Train Home,0:51–1:39
画面从列车内演唱开始,接着是街头持麦、雨夜行走、高架列车空镜,最后回到歌手。行走和空镜期间,歌曲仍在继续。没有歌手出镜,并不意味着这一段必须没有人声。
人物依然可辨认,但跨镜头的外套材质和剪裁有变化。行走镜头先从正面靠近人物,再移到侧面,没有全程按提示词要求侧向跟拍。这些都值得在审片时检查,不能只看到人物相似,就认定角色和运镜完全符合要求。
让照片唱歌,还是做一段音乐 MV?
先确定你要的画面。搜索“AI 音乐 MV 生成器”,可能会遇到几种不同的做法:
- 让照片唱歌:如果重点是让一个人物跟着录音演唱,可以用演唱视频流程。嘴部要看得清,并选择能用音频驱动嘴型的选项。
- 制作多镜头 MV:如果希望演唱、人物动作和环境共同讲故事,就需要分镜。并非每一镜都要有人张嘴唱歌。
- 制作音乐可视化:如果只需要抽象动态、封面动画或波形画面,就不必让人物演唱。给画面配上音乐,本身不会让嘴型跟着歌曲变化。
FlyAIgh 的音乐 MV 模式目前制作歌曲中的 30–60 秒。单独的演唱视频模式可选 10 秒到 6 分钟,但较长的演唱视频和整首歌的多镜头叙事 MV 是不同流程。
先选歌曲片段,再安排每一镜
选段时先听歌,别只填时长。尽量从一句开始前切入,给句尾留空间,再听进入副歌时是否自然。这个案例把歌曲的 0:51–1:39 变成成片中的 0:00–0:48。下面使用成片时间,方便边看边核对。
| 视频时间 | 镜头类型 | 作用 |
|---|---|---|
| 0:00–0:11 | 演唱 | 列车窗边的演唱,交代人物与归途。 |
| 0:11–0:22 | 演唱 | 街头表演让歌手更靠近观众。 |
| 0:22–0:33 | 剧情 | 角色穿过湿滑街道,推动旅程,同时歌曲继续。 |
| 0:33–0:41 | 空镜 | 驶过的火车和倒影展示城市;人声在画外继续。 |
| 0:41–0:48 | 演唱 | 视频回到歌手,呈现所选片段的收尾句。 |
每一镜先定一个用途。这份分镜在演唱和情境之间切换,没有把每句歌词都做成人物特写。分镜出来后,要对着实际歌词试听切点;歌词时间轴能帮助安排剪辑,但不保证每次切镜都准确卡在鼓点上。
查看列车镜头当时使用的英文提示词
以下是项目分镜中记录的原文,描述当时想要的场景与运镜。它是生成要求,不代表成片已经实现了每个细节。
She sits by the window of a night train, rain streaking the glass and neon city lights sliding past behind her; she sings softly to herself, eyes half-closed, lost in the memory. Slow gentle push-in.在 FlyAIgh 中完成制作
新建项目时,可以从当前的音乐工作区开始。上面的历史案例用了单独的列车图和共用的主角场景图,并没有为每一镜都单独生成首帧。当前流程支持在生成视频前逐镜检查首帧。
- 上传已有的 MP3 或 WAV,选择音乐 MV。使用 Suno 歌曲时,上传你有权使用的音频文件即可,不需要重新生成歌曲,也不是粘贴 Suno 链接导入。
- 选取 30–60 秒,先试听开头和结尾,再检查歌词及时间轴。识别有误就修正,需要时导入 LRC;尽量先校准歌词,再安排切镜。
- 上传角色参考图,选择视觉风格。把人物服装和场景分开描述;需要连续的镜头,先统一发型、外套、配饰和麦克风。重新准备人物图时,选五官清楚、无遮挡的画面。
- 检查分镜里的演唱、剧情和空镜类型,以及各镜的时长和提示词。生成视频前逐镜查看或替换首帧:空镜里不要误带歌手,演唱镜头则要看得清嘴。
- 选择视频模型,核对报价。H3 增强版演唱镜头会用对应歌曲片段驱动;这个工作区的 Seedance 选项不保证口型同步。开始前确认图片、歌曲选段和分镜都正确。
- 等各镜生成完成,带声音检查合成 MP4。需要歌词时另行下载 SRT。SRT 不会自动变成 MP4 画面里的字幕,要显示歌词,还需在剪辑软件中加入并导出。
视频生成需要付费账户和积分,生成图片、视频及追加尝试都会影响成本。已有歌就不需要再生成一首。提交前查看当前页面的报价,不根据这条样片估算自己的费用。
完整审片:嘴型、角色和接缝
先带声音完整播放一遍,再逐个回看切镜和演唱段。这个案例需要重点看 0:11、0:22、0:33、0:41,以及整段的开头和结尾。
- 听音轨:对照所选歌曲片段,检查有没有漏词、重复、音量突变或句尾被切断。原曲在这段之后还有内容;视频里的淡出只是选段收尾。
- 看嘴型:把听到的歌词和演唱镜头中的嘴部动作对照。配乐正确,不代表辅音、停顿和拖长音都对得上;嘴巴会动也不等于对口型合格。
- 看人物和动作:检查眼睛、握麦的手、发型、外套和道具。在切镜处暂停,对比首帧。本例的外套差异,在输入图里就已经存在。
- 看剪辑:分清有意换场景和意外跳切。空镜要接得上歌曲的情绪,结尾也要给画面留出落稳的时间。最后判断的是合成后的整片,不能只看单镜。
生成失败时,结果页可以重试失败或尚未开始的镜头。但这不等于能随意重剪已经完成的项目:生成一旦启动,歌曲选段和分镜就会锁定。这些选择应在开始前确认;之后需要改变时,要另建项目。
案例核查与延伸阅读
本案例对照了保存的项目与生成记录、原始素材、完整成片和音轨。音频比较用于确认歌曲选段,没有拿它给嘴型同步打分。全片做过工具辅助的有声审查,也逐镜检查了画面;这些核查不能证明逐帧口型精准、成功率,或其他语言的歌曲也会得到同样效果。
想比较不同做法,可以看 Adobe 对“生成短镜头,再加入音乐”的说明,以及 OpenArt 从音频开始规划音乐视频的介绍。这些是厂商自己的流程说明,不是 FlyAIgh 的独立评测,也不能证明本例嘴型完美。
常见问题
照片会改变歌手的声音吗?
不会。角色照片决定外观,上传的录音提供声音。让照片中的人物看起来在唱歌,不是声音克隆,也不会把歌曲重新唱成这个人的声音。
我可以使用自己的歌或 Suno 歌曲吗?
可以,请上传你有权使用的 MP3 或 WAV。本示例中的歌曲由 Suno 生成,并且在规划视频前已被选定。使用该工作流本身不会授予你对他人录音或图片的权利。
我能把整首歌变成叙事音乐MV吗?
目前 FlyAIgh 的音乐 MV 模式制作 30–60 秒选段。另一个演唱视频模式支持 10 秒到 6 分钟,但它侧重人物演唱,不等于整首歌的多镜头叙事 MV。
所有镜头都需要口型同步吗?
不需要。演唱镜头需要音频驱动嘴型;剧情和空镜可以继续播放同一首歌,而不出现歌手。本例的列车空镜中,人声仍在继续。
为什么角色在镜头之间换了衣服?
先对比输入图片。固定人脸参考,不会同时锁住每件衣服、道具和光线。把服装描述清楚,将各镜首帧放在一起检查,再生成视频。本例列车图和街头图的外套质感原本就不同。
这适用于其他语言的歌曲吗?
可以按同样流程准备,但界面语言、歌词识别和实际演唱效果是不同的事,仍需针对歌曲检查。本例是英文歌;文章有多种译文,不代表已经测试过所有这些语言的歌曲。
我可以下载带屏幕歌词的视频吗?
工作区会分别导出视频和 SRT 歌词文件。要在画面中显示歌词,请将 SRT 导入视频编辑器,并将字幕渲染进最终导出。
在 FlyAIgh 中制作AI音乐MV免费吗?
不免费。视频生成需要付费账户和积分。请查看图片和视频的当前报价,并为重试预留成本。上传你已有的歌曲不会使视频生成步骤免费。