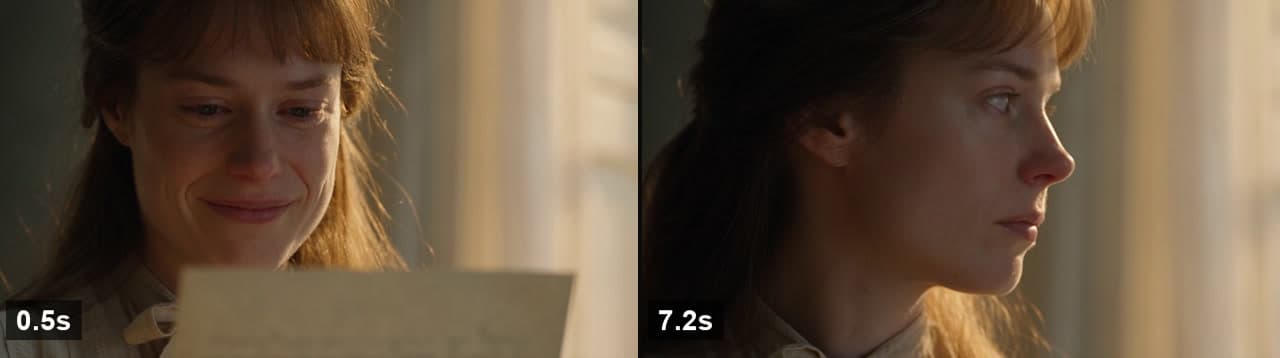
生成日期:2026-08-29(Seedance 2.5,三次尝试) · 发布:2026-09-01
结论先说
现在每一份提示词指南都会告诉你:要导演一场表演,不要只写一个情绪。但几乎没有一份 拿出成片、把每一拍的时间贴着脚本核对过,于是这条建议流传甚广,却始终没有证据。 我们把同一场戏在 Seedance 2.5 上跑了两次,两条原片都公开, 每一拍都是从帧上读出来的。
这两次生成的价值,不在于再证明一遍「动作式提示词有效」。真正值得看的是:模型 遇到自己拍不出来的那一句,会怎么办。Run A 要的是 「笑容留在嘴上但离开了眼睛」,这是只有真人演员才能同时成立的矛盾。 模型没跳过它,也没报错,而是拍了最接近的那个结果:笑容消失了。同一句话里 相邻的分句——眨两下眼、抬眼越过镜头——都正常执行了。
Run B 把同一个情绪转折改写成六件可观察的事,全程不含任何内心词汇。六件事全部出现, 在一条 8 秒的片子里,第一次生成就完成了。其中相邻的两拍,顺序跟脚本反了。
两条提示词
两次的场景相同:一个女人在读信,信里的某句话让她受了打击。同一个模型、同一天、 同样设置(720p、16:9、文生视频、无参考图)。唯一有意做出的差别,是这个情绪转折 写成了内心感受,还是写成了外部动作。
Run A,5 秒,写的是内心状态:
Close-up on a woman in her thirties reading a handwritten letter, warm window light from the left, shallow depth of field. She holds a polite smile for someone off-camera. Her eyes drop to one line and the smile stays on her mouth but leaves her eyes; her jaw tightens, she blinks twice, her breath catches. She lifts her gaze past the lens, composed again. Subtle, restrained performance. No dialogue, no music.
Run B,8 秒,只写可见事件:
Close-up on a woman in her thirties beside a window, warm afternoon light, shallow depth of field. She is smiling as she reads a letter held below frame. Her eyes move down one line and the smile fades from her face; her mouth settles flat, her gaze goes still. She lowers the letter slowly, breathes out, blinks twice, and turns to look toward the window. Quiet and restrained. No dialogue, no music.
两段篇幅相当,都不含运镜、打光变化或转场。差别只有一处:某个分句,你能不能在一张 静帧上把它指出来。
两条原片,未剪辑
两条都没有重跑、没有剪辑、没有调色。为控制文件体积去掉了音轨;两条提示词都要求 无对白无配乐,源文件本身也不带音轨。
Run A:提示词写的是情绪
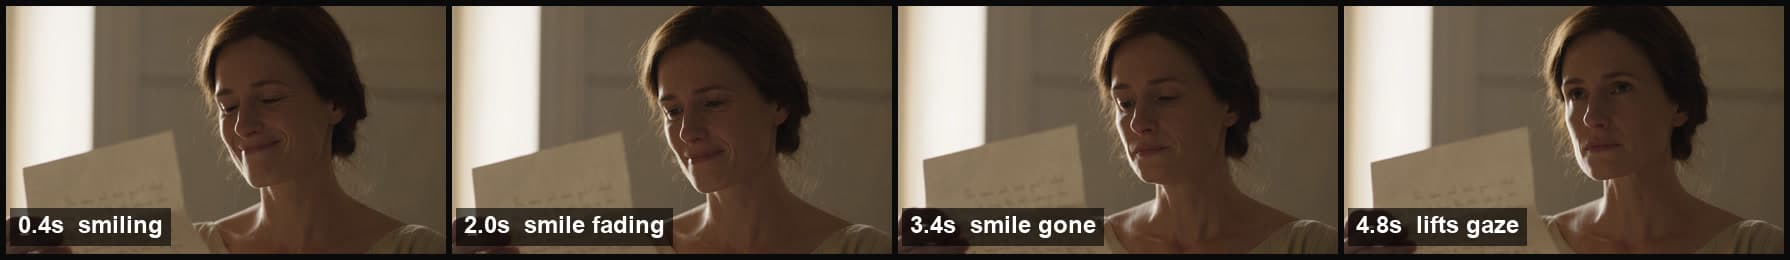
被检验的那句是 「the smile stays on her mouth but leaves her eyes」。 成片里,0.4 秒时笑容明确存在,2.0 秒时明显减弱,到 3.4 秒左右已经没有了,之后 嘴角一直是平的。「让笑容留住」这条没有被执行。
被执行的是同一句话的其余部分。视线在 4.8 秒左右抬起越过镜头,那是脚本的最后一拍, 也是成片的收尾画面。这才是结果值得琢磨的地方,而不是一次简单的失败:模型解析了 整句话,把能调度的分句都演了,把不能调度的那个换成了最近的可见邻居。一个存在着 但情绪已经抽离的笑容,不是一帧画面能容纳的东西;一个正在消失的笑容是。
这句话里还有两个更细的分句,her jaw tightens 和 her breath catches,超出了我们这个采样精度和分辨率能判定的范围, 两边我们都不打分。
Run B:提示词写的是动作
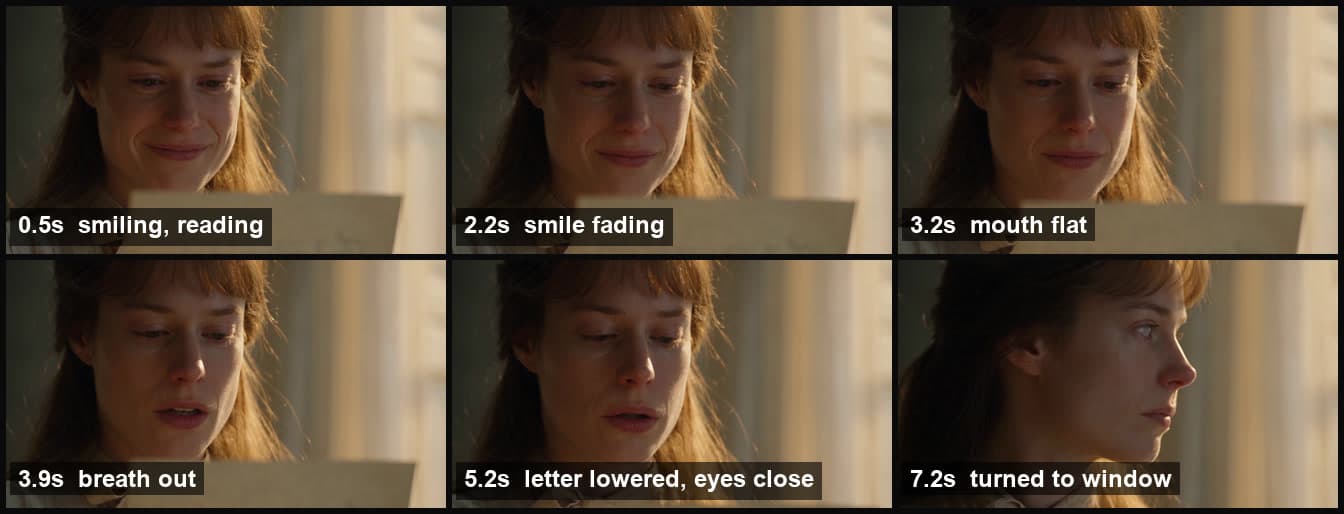
Run B 用不含任何内心词汇的写法重写了同一个转折。六件事发生,全部可见, 而且第一次生成就全在片子里:
| 脚本里的分句 | 成片中观察到 | 判定 |
|---|---|---|
| 读信时带着笑 | 0.0 到约 1.5 秒 | 执行 |
| 笑容从脸上消退 | 约 1.5 秒到 2.75 秒 | 执行 |
| 嘴角落回平直 | 约 3.0 秒 | 执行 |
| 缓缓放下信 | 约 4.5 秒到 5.5 秒之间离开画面 | 执行,偏晚 |
| 呼气 | 约 3.9 秒张开嘴 | 执行,偏早 |
| 眨两下眼 | 约 4.75 秒到 6.25 秒之间闭眼 | 执行 |
| 转头看向窗户 | 约 6.5 秒开始转,7.0 秒完全侧脸 | 执行 |
唯一打了折扣的是 blinks twice。成片给的是一次持续约一秒半的缓慢闭眼, 而不是两次分明的眨眼。情绪上是同一拍,但提示词里写的次数,模型不会照数还给你。
还有一处是模型自己加的:从第一帧起,她的眼睛看上去就已经是湿的,而这时信里的内容 还没读到。提示词只说了她读信时带着笑。这是我们的主观判断;不过对一个主打电影质感的 模型来说,这个脾气值得记一笔——它会把自己对这场戏的理解一并带进来。
有两拍的顺序反了
脚本写的是 she lowers the letter slowly, breathes out, blinks twice。 成片先呼气,在约 3.9 秒,信随后才离开画面,大约在 4.5 到 5.5 秒之间。两件事都发生了, 顺序颠倒。
如果你写拍点是为了跟别的素材对切,这一点就有影响。整体走向是稳的:片子以微笑开场、 以侧脸收尾,跟脚本完全一致,也没有任何一拍被丢掉。但相隔一秒以内的相邻拍点,要当成一组事件看——模型会在那一带把它们排完, 却不保证先后。我们另一篇 25 秒带时间码的实测 在更大尺度上观察到同一种性质:时间区间会带动节奏,但不会固定切点。
第三次生成被拒了
在 Run A 和 Run B 之间,我们还试过第三版。它是同一场戏,往每一份提示词指南推荐的 方向——更具体的物理描述——推得更狠:
Extreme close-up on a woman's face in her thirties [...] Her eyes track down one line and her smile drops away completely: the mouth goes flat, her eyes widen, she stops moving for a full beat. Her fingers crush the edge of the paper, crumpling it. She swallows hard, blinks fast twice, then turns her face away from the letter toward the window.
这次生成被内容审核拒绝,错误码 1501,没有产出任何片子,也没有计费。 同样六拍的温和写法(Run B)在下一次尝试中通过了。
我们把这次拒绝作为一个观察到的结果报告,不去猜触发点在哪。三个要素是同时改动的 (极端特写的取景、捏皱信纸、瞪大眼睛),单次拒绝没法把原因归到其中任何一个头上。 但它确实说明了一件事:那条标准建议有个没人写出来的上限——拍写实人物特写时, 物理描述越写越狠,走的正是撞上审核墙的那条路。我们 对 11 个模型实测的拒绝率 显示,同一个输入在一些模型通过、在另一些被拒是常态,所以这一次被拒,说的是这一次尝试,不是这场戏本身有问题。
怎么核对你自己的成片
上面这些,用正常速度看片是读不出来的。一个横跨 1.25 秒的笑容消退、一次发生在 3.9 秒的呼气,是把帧并排放在一起才能找到的东西。工具就是一条命令:
# a 4x4 contact sheet covering 4 seconds at 0.25s spacing
ffmpeg -i clip.mp4 -vf "fps=4,scale=320:-2,tile=4x4" -frames:v 1 sheet.png

# start the window later in the clip
ffmpeg -ss 4 -t 4 -i clip.mp4 -vf "fps=4,scale=320:-2,tile=4x4" -frames:v 1 late.png
从左到右、从上到下读这张表,手边对着提示词一句一句核。这篇文章里的每一条判断 都是这么产生的,而且帧的位置都写了出来,你可以拿公开的原片自己复现。
video.currentTime 然后画到 canvas 上——可能会一遍遍返回同一帧, 不抛异常,也不打任何警告。我们一开始就是这么做的。它产出两张联络表,一张 8 帧、一张 24 帧,每一格都一模一样,我们据此发布过一个连错两轮的结论,直到改用 ffmpeg 重新核对才纠正。如果你的联络表显示一条什么都没发生的片子,先怀疑工具,再怀疑模型。方法与边界
- 一个模型,一场戏,三次尝试。三次都是 2026-08-29 通过文生视频 调用 Seedance 2.5,720p、16:9,直接提交给供应商 API 而非经由我们自己的界面。 这不是模型横评,也说不出别的模型会怎么处理表演指令。
- 第一次尝试,没有重跑。留下的每条片子都是这条提示词唯一的一次生成, 没有从一批里挑。同一条提示词再跑一次,结果都可能不一样。
- 时间是采样得到的,不是精确值。帧是用 ffmpeg 按 0.25 到 0.5 秒 的间隔抽的,所以这里每个时间点都有这么大的误差。能写成区间的地方,我们就写区间。
- 有两个分句没有打分。Run A 里的「jaw tightens」和 「breath catches」比我们的采样精度更细,我们选择不打分而不是猜。
- 两次生成的时长不同。Run A 是 5 秒,Run B 是 8 秒。Run B 完成度 更高有一部分来自多出来的三秒,不全是措辞的功劳。但那句拍不出来的指令,结论 跟时长无关:Run A 的笑容 3.4 秒就没了,远在它自己的片长之内。
- 读脸是主观的。「笑容没了」「嘴角平了」「眼睛已经是湿的」都是 我们的判读。两条原片都完整公开,你可以抽同样的帧然后反驳。
按发布时的定价,Run A 花了 77 积分,Run B 花了 122 积分,720p 下为每秒 15.3 积分。 一个积分大致在 $0.018 到 $0.030 之间,取决于套餐,因此整次测试(含被拒的那一次) 总成本在 $6 以内。
FAQ
AI 视频模型会执行表演指令吗?
在这次测试里,凡是镜头能拍到的都执行了,拍不到的只做了近似。两次生成都完成了各自的可见指令:眨眼、转头、把信放下、笑容变化。唯一没有执行的,是那句描述内心状态的「笑容留在嘴上但离开了眼睛」——这是只有真人演员才能同时成立的矛盾,模型挑了最接近、又拍得出来的做法:让笑容直接消失。指令没被丢掉,只是被换成了镜头拍得到的版本。
为什么我的 AI 视频里人物整条片子表情都不变?
最常见的原因是提示词写的是一个情绪,而不是一串可见的变化。「她很心碎」只给了模型一个状态,它就会把这个状态端到底。给它一串可观察的事件,它才有东西可以随时间调度:笑容消退、嘴角变平、放下信、呼气、眨眼、转向窗户。我们那条 8 秒的成片里,这六件事全部出现了。时长也有关系:5 秒的片子大概只装得下两三个变化,装不下六个。
AI 视频提示词里该写情绪还是写物理动作?
写物理动作。不过这条建议有个代价,提示词指南几乎都不提。动作是模型能渲染、你事后能逐帧核对的东西。可是在写实人物特写上,物理描述越具体,越容易撞上内容审核。我们这场戏的第三次生成把措辞改成 extreme close-up、her fingers crush the edge of the paper、her eyes widen,结果被 1501 错误拒绝,而同样六拍的温和写法(Run B)顺利通过。可用的中间地带是:具体、可观察、但不激烈——描述发生了什么变化,而不是变化有多剧烈。
AI 视频模型会按提示词里写的顺序执行动作吗?
大致会,但不严格。我们那条 8 秒成片六拍全中,可是相邻的两拍换了位:脚本写的是先放下信再呼气,成片里呼气发生在 3.9 秒左右,而信离开画面是在大约 4.5 到 5.5 秒之间。整体走向(从微笑到转身)跟脚本一致。把一串拍点看成一组事件,模型会大致按那个次序铺开,但它不是剪辑时间轴。相隔不到一秒的两拍,别指望顺序。
怎么检查一条 AI 视频到底有没有按提示词执行?
用 ffmpeg 按固定间隔抽帧,然后把帧和提示词的每个分句对着读。命令是 ffmpeg -i clip.mp4 -vf "fps=4,scale=320:-2,tile=4x4" -frames:v 1 sheet.png,能得到一张覆盖 4 秒、间隔 0.25 秒的联络表。不要用那个看起来最顺手的浏览器办法(给 video 元素设 currentTime 再画到 canvas 上):它可能反复返回同一帧且不报任何错,我们就是这么干的,因此连续得出过两个错误结论,换成 ffmpeg 才纠正过来。
Every model in this article, on one account
Prices and capabilities for each model are on their own pages, and the price of a run is shown before you start it.