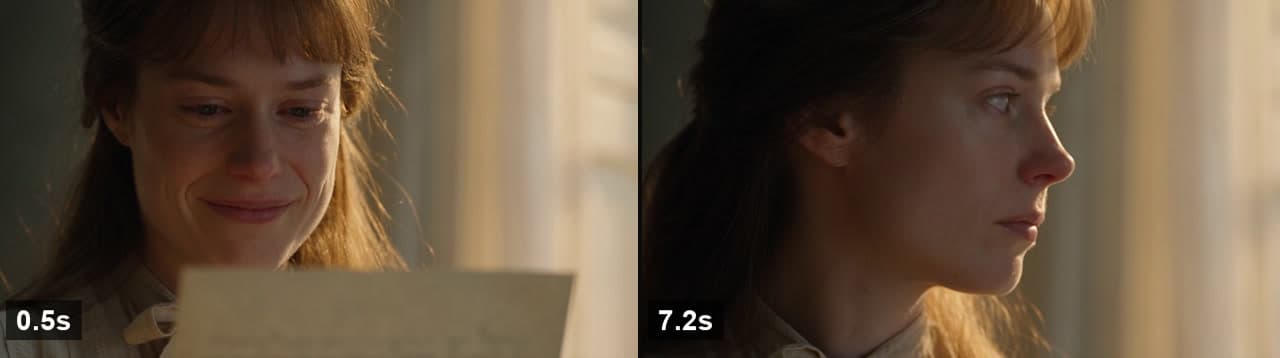
生成日:2026-08-29(Seedance 2.5、3 回試行) · 公開:2026-09-01
結論から
いまやどのプロンプト指南も、感情を一語で書くのではなく演技を演出せよと説きます。 ところが完成尺を示し、各ビートの時刻を脚本と突き合わせたものはほとんどありません。 そのため助言だけが広まり、証拠は出てこないままでした。私たちは同じ場面を Seedance 2.5 で 2 回生成し、2 本とも公開したうえで、 各ビートをフレームから読み取りました。
この 2 本の価値は、動作ベースのプロンプトが有効だと再確認することではありません。 見るべきなのは、モデルが自分に撮れない一文をどう扱うかです。Run A が求めたのは 「笑みは口元に残るが目からは消える」、生身の俳優にしか成立させられない矛盾でした。 モデルはこれを飛ばしもせず、エラーも返さず、最も近い可視の結果を描きました。 笑みが消えたのです。同じ文の隣の節、まばたき 2 回とレンズの先へ視線を上げる動作は、 いずれも正しく実行されました。
Run B は同じ感情の転換を、内面の語を一切使わずに 6 つの観察可能な出来事として書き直したものです。 6 つはすべて、8 秒の生成の一発目で画面に出ました。そのうち隣り合う 2 つは、脚本と順序が逆になりました。
2 本のプロンプト
場面は同じです。女性が手紙を読み、その一行が彼女を打ちのめします。 モデルも日付も設定も同じで(720p、16:9、テキストから動画、参照画像なし)、 意図して変えたのは 1 点だけ、感情の転換を内面として書くか、外形の動作として書くかです。
Run A、5 秒、内面の状態を書いたもの:
Close-up on a woman in her thirties reading a handwritten letter, warm window light from the left, shallow depth of field. She holds a polite smile for someone off-camera. Her eyes drop to one line and the smile stays on her mouth but leaves her eyes; her jaw tightens, she blinks twice, her breath catches. She lifts her gaze past the lens, composed again. Subtle, restrained performance. No dialogue, no music.
Run B、8 秒、可視の出来事だけを書いたもの:
Close-up on a woman in her thirties beside a window, warm afternoon light, shallow depth of field. She is smiling as she reads a letter held below frame. Her eyes move down one line and the smile fades from her face; her mouth settles flat, her gaze goes still. She lowers the letter slowly, breathes out, blinks twice, and turns to look toward the window. Quiet and restrained. No dialogue, no music.
分量はほぼ同じで、どちらにもカメラワーク、照明の変化、トランジションは含まれていません。 違いは 1 点だけです。その節を、静止した 1 フレームの上で指させるかどうかです。
2 本の原素材(無編集)
いずれも再生成、トリミング、カラーグレーディングは行っていません。 ファイルサイズのため音声トラックは外していますが、どちらのプロンプトも台詞と音楽を求めておらず、 元ファイルにも音声トラックはありませんでした。
Run A:感情を書いたプロンプト
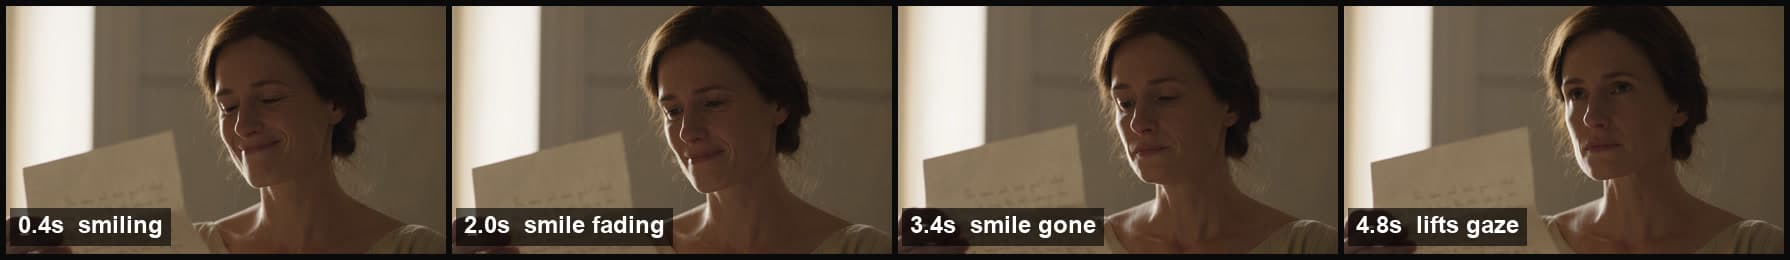
検証対象の一文は 「the smile stays on her mouth but leaves her eyes」 です。 完成尺では 0.4 秒の時点で笑みがはっきりあり、2.0 秒で目に見えて弱まり、 3.4 秒あたりで消えています。以降、口元は最後まで平らなままです。 笑みを保てという指示は実行されませんでした。
実行されたのは同じ文の残りの部分です。4.8 秒あたりで視線がレンズの先へ上がります。 これは脚本の最後のビートであり、この生成の締めの絵でもあります。 結果が単なる失敗ではなく検討に値するのはこの点です。モデルは文全体を解釈し、 演出できる節はすべて演じ、できない一つだけを最も近い可視の隣接物に置き換えました。 存在してはいるが感情の抜けた笑みは、1 フレームに収まるものではありません。 消えていく笑みなら収まります。
この文にはさらに細かい節が 2 つあります。her jaw tightens と her breath catches です。今回のサンプリング精度と解像度では判定できる範囲を超えるため、 どちらにも点はつけません。
Run B:動作を書いたプロンプト
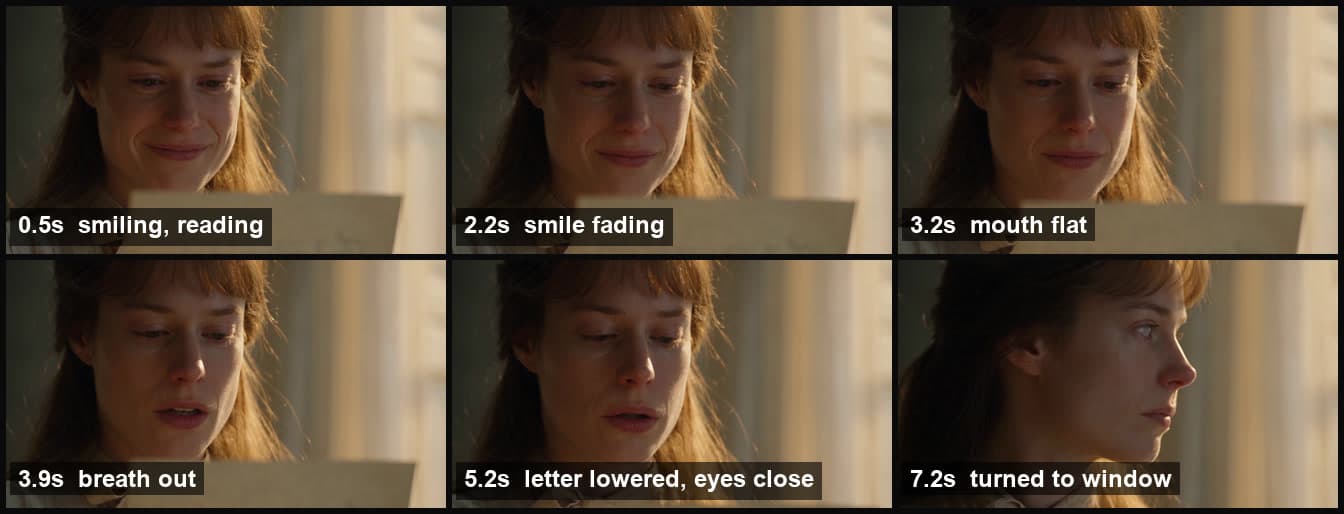
Run B は同じ転換を、内面の語彙を使わずに書き直したものです。 6 つの出来事が起き、いずれも可視で、しかも一発目からすべて画面に出ています。
| 脚本の節 | 完成尺で観測された時刻 | 判定 |
|---|---|---|
| 手紙を読みながら微笑む | 0.0 秒から約 1.5 秒 | 実行 |
| 笑みが顔から消えていく | 約 1.5 秒から 2.75 秒 | 実行 |
| 口元が平らに戻る | 約 3.0 秒 | 実行 |
| 手紙をゆっくり下ろす | 約 4.5 秒から 5.5 秒の間に画面外へ | 実行、やや遅い |
| 息を吐く | 約 3.9 秒に口が開く | 実行、やや早い |
| まばたきを 2 回 | 約 4.75 秒から 6.25 秒の間に閉眼 | 実行 |
| 窓の方へ顔を向ける | 約 6.5 秒に回り始め、7.0 秒で完全な横顔 | 実行 |
唯一割り引かれたのは blinks twice です。完成尺が返したのは約 1 秒半かけた ゆっくりした閉眼で、明確な 2 回のまばたきではありません。感情としては同じビートですが、 プロンプトに書いた回数がそのまま返ってくるわけではないということです。
モデルが自分で足したものも 1 つあります。最初のフレームからすでに彼女の目が潤んで見えるのですが、 この時点で手紙の中身にはまだ達していません。プロンプトは、手紙を読みながら微笑んでいるとしか書いていません。 これは私たちの主観的な読みです。ただし映画的な質感を売りにするモデルについては、 この癖は記しておく価値があります。モデルはこの場面についての自分の解釈を、一緒に持ち込んできます。
2 つのビートの順序が入れ替わりました
脚本は she lowers the letter slowly, breathes out, blinks twice の順です。 完成尺では先に息を吐くのが約 3.9 秒、手紙が画面から外れるのはそのあと、 およそ 4.5 秒から 5.5 秒の間でした。どちらの出来事も起きていますが、順序が逆です。
他の素材と合わせて切るためにビートを書いているなら、この点は効いてきます。 全体の流れは崩れていません。微笑みで始まり横顔で終わる構成は脚本と完全に一致し、 落ちたビートも 1 つもありません。ただし 1 秒以内に隣り合うビートは、 モデルがその周辺にまとめて配置する出来事の組として扱ってください。前後は保証されません。 もう一本の 25 秒のタイムコード付き検証 では、より大きな尺度で同じ性質が観測されています。時間の区間はテンポを動かしますが、 カット点を固定はしません。
3 回目の生成は拒否されました
Run A と Run B の間に、3 つ目の版も試しています。同じ場面を、 どのプロンプト指南も勧める方向、つまりより具体的な物理描写へさらに押し込んだものです。
Extreme close-up on a woman's face in her thirties [...] Her eyes track down one line and her smile drops away completely: the mouth goes flat, her eyes widen, she stops moving for a full beat. Her fingers crush the edge of the paper, crumpling it. She swallows hard, blinks fast twice, then turns her face away from the letter toward the window.
この生成はコンテンツ審査で拒否されました。エラーコードは 1501、 映像は 1 本も出ておらず、課金もされていません。同じ 6 ビートを穏やかな表現で書いた Run B は、 次の試行で通っています。
この拒否は観測された結果として報告するにとどめ、何が引き金だったかは推測しません。 3 つの要素を同時に変えているため(極端なクローズアップの画角、紙を握りつぶす動作、見開いた目)、 1 回の拒否から原因を 1 つに帰することはできません。ただし確かに言えることが 1 つあります。 あの定番の助言には、誰も書いていない上限があるということです。実写的な人物のクローズアップでは、 物理描写を強めていく方向が、そのまま審査の壁に向かう方向でもあります。 私たちが 11 モデルで実測した拒否率 が示すとおり、同じ入力があるモデルでは通り別のモデルでは拒否されるのは日常茶飯事です。 ですからこの 1 回の拒否は、この試行についての事実であって、この場面の性質ではありません。
自分の生成物を検証する方法
ここまでの内容は、等倍で再生して眺めても読み取れません。1.25 秒かけて消えていく笑みや、 3.9 秒に起きる呼吸は、フレームを並べて初めて見つかるものです。道具はコマンド 1 つで足ります。
# a 4x4 contact sheet covering 4 seconds at 0.25s spacing
ffmpeg -i clip.mp4 -vf "fps=4,scale=320:-2,tile=4x4" -frames:v 1 sheet.png

# start the window later in the clip
ffmpeg -ss 4 -t 4 -i clip.mp4 -vf "fps=4,scale=320:-2,tile=4x4" -frames:v 1 late.png
左から右、上から下へこのシートを読み、手元でプロンプトの各節と 1 つずつ照らし合わせてください。 この記事の判断はすべてこの方法で出したもので、フレームの位置も書いてあります。 公開した原素材でそのまま再現できます。
video.currentTime を動かして canvas に描く手順は、 同じフレームを何度も返すことがあります。例外も投げず、警告も出しません。 私たちは最初にこれをやりました。8 フレームと 24 フレームの 2 枚のコンタクトシートが出て、 どのコマも同一で、その結果 2 度続けて誤った結論を公開しかけ、 ffmpeg で確認し直してようやく訂正しました。何も起きていない映像に見えるシートが出たら、 モデルより先に道具を疑ってください。方法と限界
- 1 モデル、1 場面、3 回の試行です。3 回とも 2026-08-29 に Seedance 2.5 のテキストから動画を、720p、16:9 で、自社の画面を経由せず ベンダー API に直接投げています。これはモデル間の比較ではなく、 他のモデルが演技指示をどう扱うかについては何も述べられません。
- 一発目のみで、再生成はしていません。残した各素材はそのプロンプトの 唯一の生成で、複数から選んだものではありません。同じプロンプトをもう一度回せば、 結果は変わりうるものです。
- 時刻はサンプリング値で、正確値ではありません。フレームは ffmpeg で 0.25 秒から 0.5 秒の間隔で抜いているため、ここに書いた時刻にはその分の誤差が乗ります。 区間として書ける箇所を区間で書いているのはそのためです。
- 2 つの節には点をつけていません。Run A の「jaw tightens」と 「breath catches」は今回のサンプリング精度より細かいため、推測せず未判定としました。
- 2 本の尺が違います。Run A は 5 秒、Run B は 8 秒です。 Run B の完成度が高いことの一部は、多い 3 秒ぶんによるもので、書き方だけの成果ではありません。 ただし撮れない一文についての結論は尺に依存しません。Run A の笑みは 3.4 秒で消えており、 自分の尺のうちに十分収まっています。
- 顔を読むことは主観的です。「笑みが消えた」「口元が平ら」「目がすでに潤んでいる」 はいずれも私たちの読みです。2 本とも完全版を公開しているので、 同じフレームを抜いて反論することができます。
公開時点の価格では、Run A が 77 クレジット、Run B が 122 クレジット、 720p で 1 秒あたり 15.3 クレジットです。1 クレジットはプランによりおよそ $0.018 から $0.030 なので、拒否された 1 回を含めた検証全体でも $6 に収まります。
FAQ
AI 動画モデルは演技指示に従いますか。
この検証では、カメラが写せるものはすべて実行され、写せないものは近似だけが返りました。2 本とも可視の指示は完了しています。まばたき、首の動き、手紙を下ろす動作、笑みの変化です。実行されなかったのは内面の状態を述べた一文、「笑みは口元に残るが目からは消える」だけでした。これは生身の俳優にしか成立させられない矛盾で、モデルは最も近い撮影可能な形を選びました。笑みをそのまま消したのです。指示は無視されたのではなく、目に見えるものへ置き換えられました。
AI 動画の人物が最後まで同じ表情のままなのはなぜですか。
よくある原因は、プロンプトが可視の変化の連なりではなく一つの感情を書いていることです。「彼女は打ちのめされている」は状態を一つ渡すだけなので、モデルはその状態を最後まで保ちます。観察できる出来事を連ねれば、時間に沿って配置できる素材が渡ります。笑みが消える、口元が平らになる、手紙を下ろす、息を吐く、まばたきする、窓の方を向く。8 秒の生成では、この 6 つがすべて画面に出ました。尺も関係します。5 秒に収まる変化は 2 つか 3 つで、6 つは入りません。
AI 動画のプロンプトには感情と物理的な動作のどちらを書くべきですか。
物理的な動作です。ただしプロンプト指南がほとんど触れない代償が一つあります。動作はモデルが描けるもので、あとからフレーム単位で検証できるものでもあります。しかし実写的な人物のクローズアップでは、物理描写を具体的にするほどコンテンツ審査に当たりやすくなります。同じ場面の 3 回目の生成で extreme close-up、her fingers crush the edge of the paper、her eyes widen と書き換えたところ、1501 エラーで拒否されました。同じ 6 ビートを穏やかな表現で書いた Run B は通っています。使える中間地帯は、具体的で、観察可能で、しかし激しくない書き方です。何が変わるかを書き、どれほど激しいかは書かないことです。
AI 動画モデルはプロンプトに書いた順序どおりに動作を実行しますか。
おおむね従いますが、厳密ではありません。8 秒の生成では 6 つのビートがすべて出ましたが、隣り合う 2 つが入れ替わりました。脚本では手紙を下ろしてから息を吐く順ですが、完成尺では息を吐くのが 3.9 秒あたり、手紙が画面から外れるのがおよそ 4.5 秒から 5.5 秒の間です。全体の流れ、つまり微笑みから背を向けるまでは脚本どおりでした。ビートの並びは編集タイムラインではなく、モデルがおおよそその範囲に配置する出来事の集合として扱ってください。1 秒未満しか離れていない 2 つのビートの前後関係は当てにできません。
AI 動画が本当にプロンプトどおりに動いたかを確かめるには。
ffmpeg で一定間隔のフレームを書き出し、プロンプトの各節と並べて読みます。ffmpeg -i clip.mp4 -vf "fps=4,scale=320:-2,tile=4x4" -frames:v 1 sheet.png で、4 秒ぶんを 0.25 秒間隔で並べたコンタクトシートが得られます。いちばん手軽に見えるブラウザでの方法、つまり video 要素の currentTime を動かして canvas に描く手順は使わないでください。同じフレームを何度も返すことがあり、しかもエラーは一切出ません。私たちはまさにそれをやり、2 度続けて誤った結論を出したあと、ffmpeg に切り替えて訂正しました。
Every model in this article, on one account
Prices and capabilities for each model are on their own pages, and the price of a run is shown before you start it.