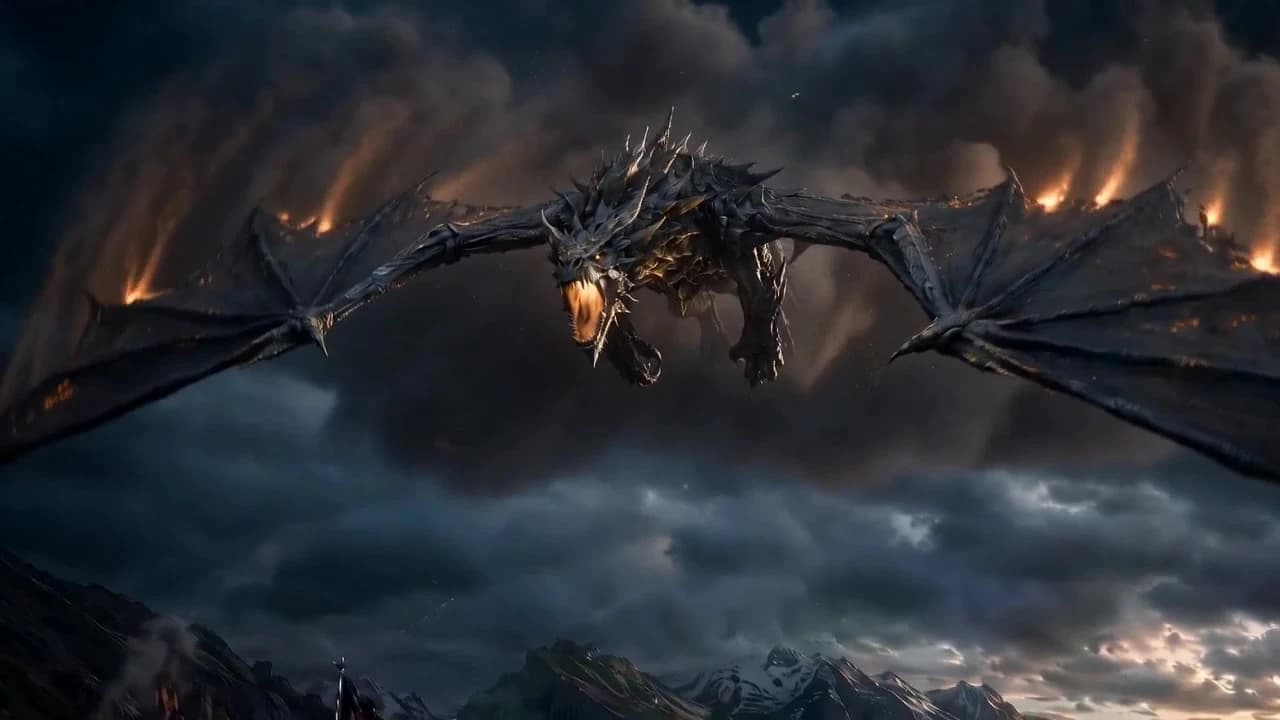
提示词指南给你的,往往是为了那篇文章现写的模板。这一篇拆的是 381 条真正跑过、也真出了片的提示词,取自 52 部完成的作品。 它们是被编译出来的、不是手打的,而这恰恰是有用的地方:同样的结构在全部提示词里 重复出现,清晰到可以直接照搬。
五个部分,按顺序
- 风格块——镜头、胶片、色板、颗粒。同一部片子的每个镜头里完全一致。
- 帧绑定——这段片子是从给定图片开始并结束,还是只有开头被钉住。
- 主体一致性条款——谁必须从头到尾长得一样。
- 角色档案——每个主体的具体外形描述。
- 带时间码的动作——时长切成若干段,每段有自己的动作。
一条完整提示词平均大约 850 个字符。这个长度大部分来自第 4 和第 5 部分, 而这两部分存在的理由相同:把模型本来会替你做的决定收回来。
这些提示词从哪来
52 部完成作品里的 381 条分镜提示词,全部在 FlyAIgh 上生成。下面的结构分析和每一个计数 覆盖的都是全集。引用原文的只有我们自己的板子——别人的剧本是别人的事, 它们只进统计,不进引用。
逐段拆解
1. 风格块。用方括号包起来,放在最前面,并在同一部片子的每个镜头里逐字重复:
注意它装了什么:一个画幅格式(large-format anamorphic)、具体的颜色语言 (slate-blue、ember-orange、molten-gold)、一种光的行为(volumetric god-rays)、 材质(hammered steel、rune-etched stone),以及一个胶片特性(35mm halation bloom)。 它一个字都没写动作。
重复本身就是要点。每一次生成都是一次独立调用,对上一次没有记忆——凡是你不重述的, 都会被重新发明。七个镜头看起来像同一部片子,靠的就是这七个完全相同的风格块。
2. 帧绑定。一句话,按这个镜头有没有目标结束画面分成两种写法:
- "Video starts from the first reference image (frame 1: opening pose) and ends at the second reference image (frame N: closing pose)." —— 首尾都钉住。
- "Video starts from the first reference image (opening frame: composition and pose). From there the action plays out naturally per the motion description — the ending is not pinned to a target still." —— 只钉住开头。
第二种写法值得留意。首尾都钉住买到的是精度,代价是自然度,因为模型必须走到一个指定的 地方去。当这个镜头只需要动得可信时,把结尾放开反而能出更好的运动。
3. 主体一致性条款。写得很明确,而且直接点名:
4. 角色档案。每个被点名的主体都有一段压缩过的外形描述,属性用分号隔开:
它跟参考图是并行的,不是替代关系。图承载相貌,文字承载图钉不住的东西——尺度 ("~40m wingspan filling the frame")、气质("road-hardened"), 以及什么是刻意不存在的(本该长鬃毛的位置写着 "none")。
5. 带时间码的动作。这一部分最能把它们和普通提示词区分开:
先写总时长,然后是带标签的片段,然后一行镜头运动小结,最后是画幅比例。 即使在完全不出声的模型上,声音也照样描述——它不花什么成本,却能约束节奏。 "One continuous take, no cut" 之所以出现,是因为拿到多拍点描述的模型 有时会在一条片子内部自己剪一刀。
一条完整的提示词
五个部分拼在一起,跟当时真跑的一字不差——这是第 2 镜,也就是本页顶上那条龙:
没人写的那一层:切换
上面讲的全部是单个镜头。几乎没有提示词指南覆盖的那一层,是两个镜头之间发生的事——而它只有在你开始把镜头拼成序列、不再一条条单独生成时才会浮现。
这批里有 225 个镜头带着明确的转场决策,每个都写清四件事: 切法、跨过这一刀必须保住的视觉连续性、声音提前还是拖后,以及下一个镜头的开场帧从哪来。
| 切法 | 次数 | 声音提前或拖后 | 用来干什么 |
|---|---|---|---|
| clean-cut | 55 | 35 | 硬性并置——断裂本身就是目的 |
| match-action | 51 | 20 | 一个动作在这一镜起、在下一镜完成 |
| smash-cut | 28 | 13 | 情绪骤断,通常落在撞击点上 |
| eyeline-reaction | 27 | 13 | 有人在看,然后我们看到他看见了什么 |
| axial-cut | 23 | 7 | 同一轴线上推近或拉远 |
| seamless | 15 | 7 | 把两段片子缝成一个不断的运动 |
| dissolve | 14 | 14 | 时间或地点转换 |
| match-cut | 12 | 6 | 形状或运动跨过切点押韵 |
有两件事很显眼。硬切和动接动几乎打平(55 比 51)——真正有人做决定的时候, 保连续性的切法被选中的频率,和干脆断开差不多。另外,每一次叠化都带音频引导, 14 比 14 全中,而硬切带音频引导的只有四分之一。一次叠化如果声音上什么都没做, 读起来就是幻灯片。
写在决策里的三条原话,来自同一个七镜序列:
- clean-cut,J-cut 音频 —— "Hard juxtaposition cut from heroic climb to tyrant's reversal — the discontinuity is the power flip."连续性注记:保住风暴天光,并保持画面方向,让浪读起来是打在要塞上。
- match-action,L-cut 音频 —— "The reforged Crown's light flows into the lifting gesture — continuous radiance carries the cut."
- seamless,来自另一部片子 —— "Continuous action exceeds generation limit; seamless stitch preserves unbroken temporal compression."这一条是技术约束逼出的创作选择:那个运动比单次生成允许的时长还长,于是被拆开再缝上。
下一个镜头的首帧从哪来
每一次转场同时也决定了下一个镜头从哪里开始。还是这 225 个决策:
| 帧策略 | 次数 | 具体做什么 |
|---|---|---|
| fresh | 102 | 全新的开场帧,与上一镜无关联 |
| reference-prev-last | 94 | 新帧仍是生成的,但由上一镜尾帧引导 |
| blend | 14 | 两边混合影响 |
| video-extend | 8 | 直接从上一段片子的尾巴续下去 |
| reuse-prev-last | 7 | 直接拿上一镜尾帧用,不生成新的 |
最上面两行接近对半,这才是有意思的地方。大约十个镜头里有四个参考了上一帧 但没有直接复用——新帧是生成的,只是以上一镜怎么收的场为条件。 这是「完全自由」和「硬连续」之间的中间档,实践中被选中的频率几乎和从零开始一样高。 彻底复用很少(225 里 7 次),因为它把构图完全锁死了。
这些提示词跑出了什么
全文引用的那个七镜序列,按顺序拼起来。35 秒,280 积分,720p。 其中六镜跑在 Seedance 2.0 上,开场那一镜跑在 Kling V3 Omni 上——这是逐镜选的, 不是平台默认。
镜头之间没有做任何修饰。它们之间的一致性来自重复的风格块、角色档案和转场决策—— 也就是本文讲的这三样东西。
这份数据说明不了什么
- 这些提示词是编译出来的,不是打出来的。输入是剧本、锁定的风格和一组 参考素材,输出就是这个结构。这正是它如此一致的原因——也正因如此,把它当成 「人是怎么写提示词的」的证据是错的。
- 结构不等于质量。这里每一条提示词都跑通了,但本文对哪一条出的片子 好不看做任何判断。数据里根本不记录这件事。
- 这批里大部分不是英文。381 条里 311 条是中文。结构在两种语言下都成立, 但这里引用的措辞习惯来自那 70 条英文。
- 转场数据反映的是一套系统的词汇表。那八种切法是我们的导演功能能产出的 那些。换一个工具会得到不同的分布——而一个根本不提供转场层的工具,一条都产不出来。
FAQ
一条 AI 视频提示词里到底该写什么?
在 381 条生产提示词里,同样的五个块反复出现,顺序也一样:(1)风格块,装着镜头、胶片、色板和颗粒,同一部片子的每个镜头里保持完全一致;(2)帧绑定的一句话,说明这段片子是从给定的参考图开始并结束,还是只有开头被钉住;(3)主体一致性条款,点名谁必须保持不变;(4)角色档案,对每个主体给出具体的外形描述;(5)带时间码的动作块,把时长切成若干段,逐段说明发生什么。381 条平均下来,一条完整提示词大约 850 个字符。
AI 视频提示词该写多长?
这批提示词平均大约 850 个字符,比多数指南展示的一句话提示词长得多。这个长度不是灌水:其中大部分是角色档案和带时间码的动作拆解,这两样存在的理由是一样的——把模型本来会自己拿主意的那些模糊地带消掉。短提示词并不会失败,它只是把更多决定权交给了模型。
风格描述要在每个镜头里重复吗?
要,而且在这批提示词里是逐字重复的。同一部片子的每个镜头都带着完全相同的风格块——同样的镜头、同样的胶片、同样的色板。每一次生成都是一次独立调用,对上一次没有任何记忆,所以凡是你没有重述的东西都会被重新发明一遍。七个分开生成的镜头看起来像同一部片子,靠的就是重复风格块。
什么是带时间码的动作块?
不是把动作整体描述一遍,而是把时长切成带标签的片段:"Total 6s, one continuous take, no cut. 0-3s: slow push-in from the establishing silhouette toward the subject. 3-6s: camera arcs around to her hand as her fist closes on the shard." 它把节奏钉死,而不是让模型自己去分配动作在这段时长里的分布。
怎么让分开生成的 AI 镜头能剪到一起?
把切换写进提示词,而不是指望它自己长出来。这批里有 225 个镜头带着明确的转场决策,每一个都写清四件事:切法(动接动、硬切、视线-反应、叠化等等)、跨过这个切点必须保住的视觉连续性、声音是提前进还是拖后走(J-cut / L-cut),以及下一个镜头的开场帧从哪来。几乎没有任何公开的提示词指南覆盖这一层,因为它只有在你开始把镜头拼成序列、而不是一条条单独生成的时候才会出现。
下一个镜头该复用上一个镜头的尾帧吗?
有时候该,实践中大致是对半开。225 个明确决策里,102 个生成了全新的开场帧,94 个参考了上一个镜头的尾帧——意思是新帧仍然是生成的,只是被旧帧引导。只有 7 个直接复用了上一帧,8 个是从上一段视频续接。复用买到的是硬连续性,代价是构图自由度,所以它一般留给那些动作绝不能断的无缝缝合。
这些提示词是手写的吗?
不是。它们由 FlyAIgh 的导演功能从剧本、锁定的视觉风格和一组参考素材编译出来。这也是它们在 381 条里结构如此一致的原因,以及为什么同一部片子内的风格块在字节层面都相同。读它们的价值在结构本身——不管是机器还是人来拼装,这五个块都成立。
Build a consistent character on FlyAIgh
Identity refs + AI-derived persona + outfit variants, bound to a character ID that auto-injects into every model. 25 free credits, no card required.